 mw1rnp5oYbaE8t5j

MySQL 数据类型全解析:从 tinyint 越界到 enum 多选的选型艺术
围绕 tinyint 越界、float 精度丢失、varchar 长度上限、时间字段选型四个真实问题,全解析 MySQL 数据类型体系与选型要点。
【MySQL】数据类型全解析:从 tinyint 越界到 enum 多选的选型艺术 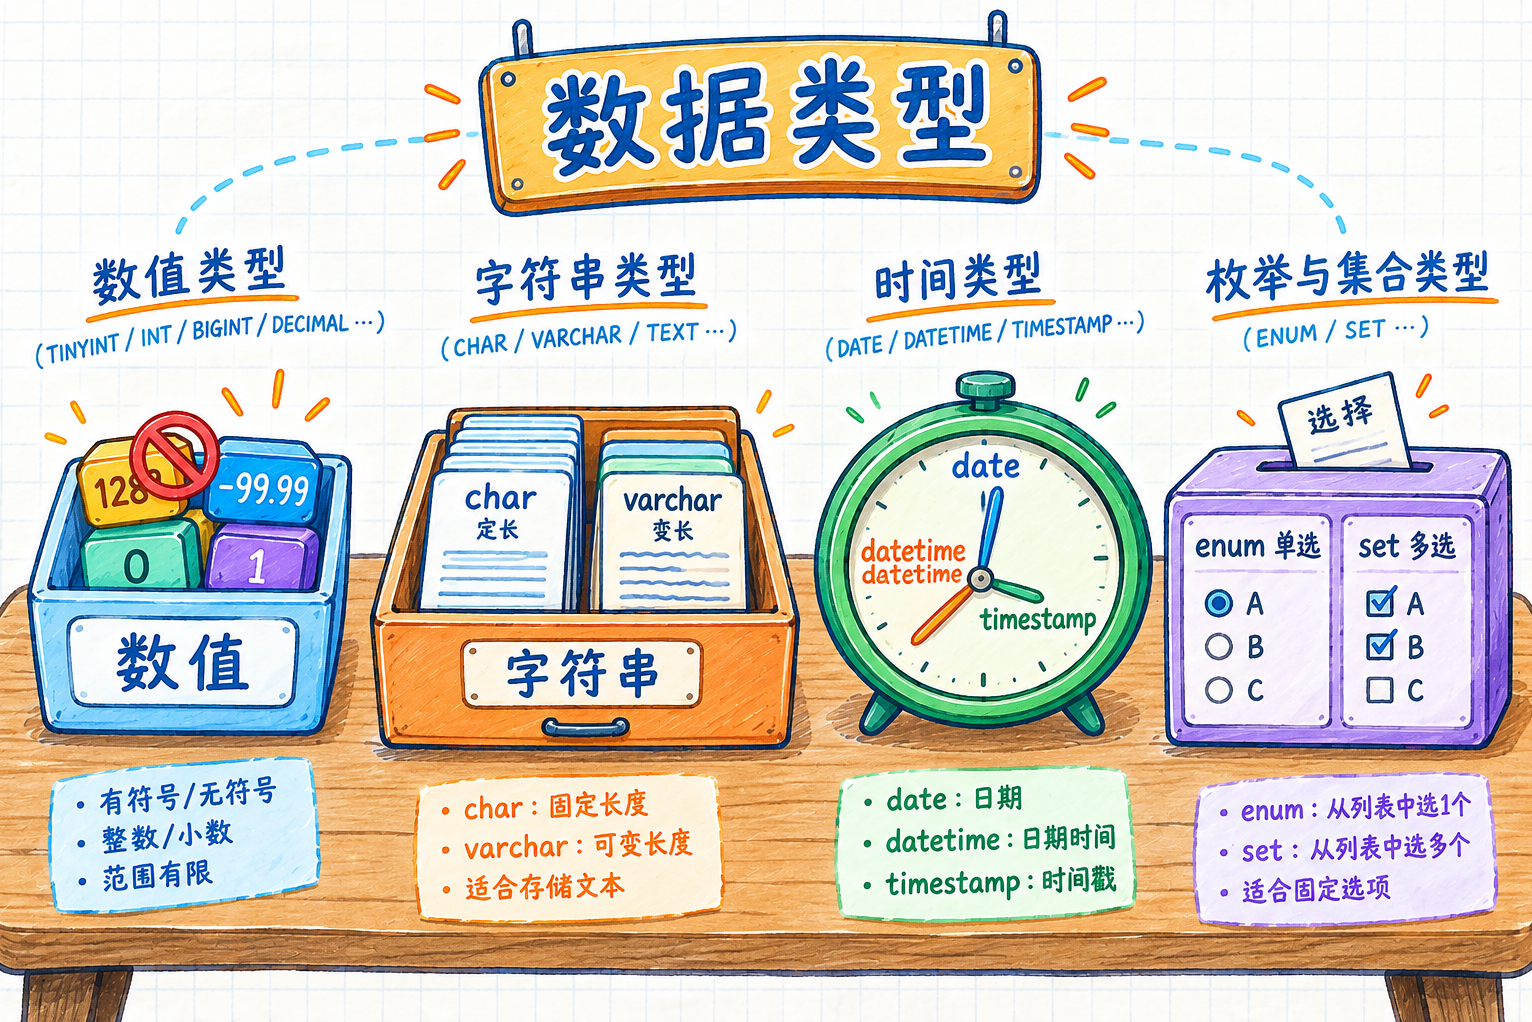
前言
适用环境:本文示例基于 MySQL 8.0.36 + InnoDB,默认字符集 utf8mb4。 涉及版本差异的语法已就地标注,完整对照见第七章;如果你的版本不同,请先执行 select version(); 确认。
上一篇我们建好了库、建好了表,但有一件事被我们刻意"糊弄"过去了——建表时每列后面的 int、varchar(20)、date 到底是什么?它们决定了这一列能存什么、存多大、怎么比、能不能存进去。
这篇文章不按"知识点清单"来罗列,而是围绕四个真实问题展开:
- tinyint 存 128 为什么会报错?为什么 bit(1) 存 2 报的却是另一种错?
- 金额字段用 float,为什么几十万条记录累加之后,账会对不上?
- varchar(255) 到底能存多长?为什么换个字符集,上限就变了?
- 时间字段该用 datetime 还是 timestamp?2038 年到底会发生什么?
把这四个问题搞清楚,越界、精度丢失、长度上限、时区与范围 这四类高频事故,你都能直接定位到对应的类型和报错码。
一、数据类型分类——四大类型
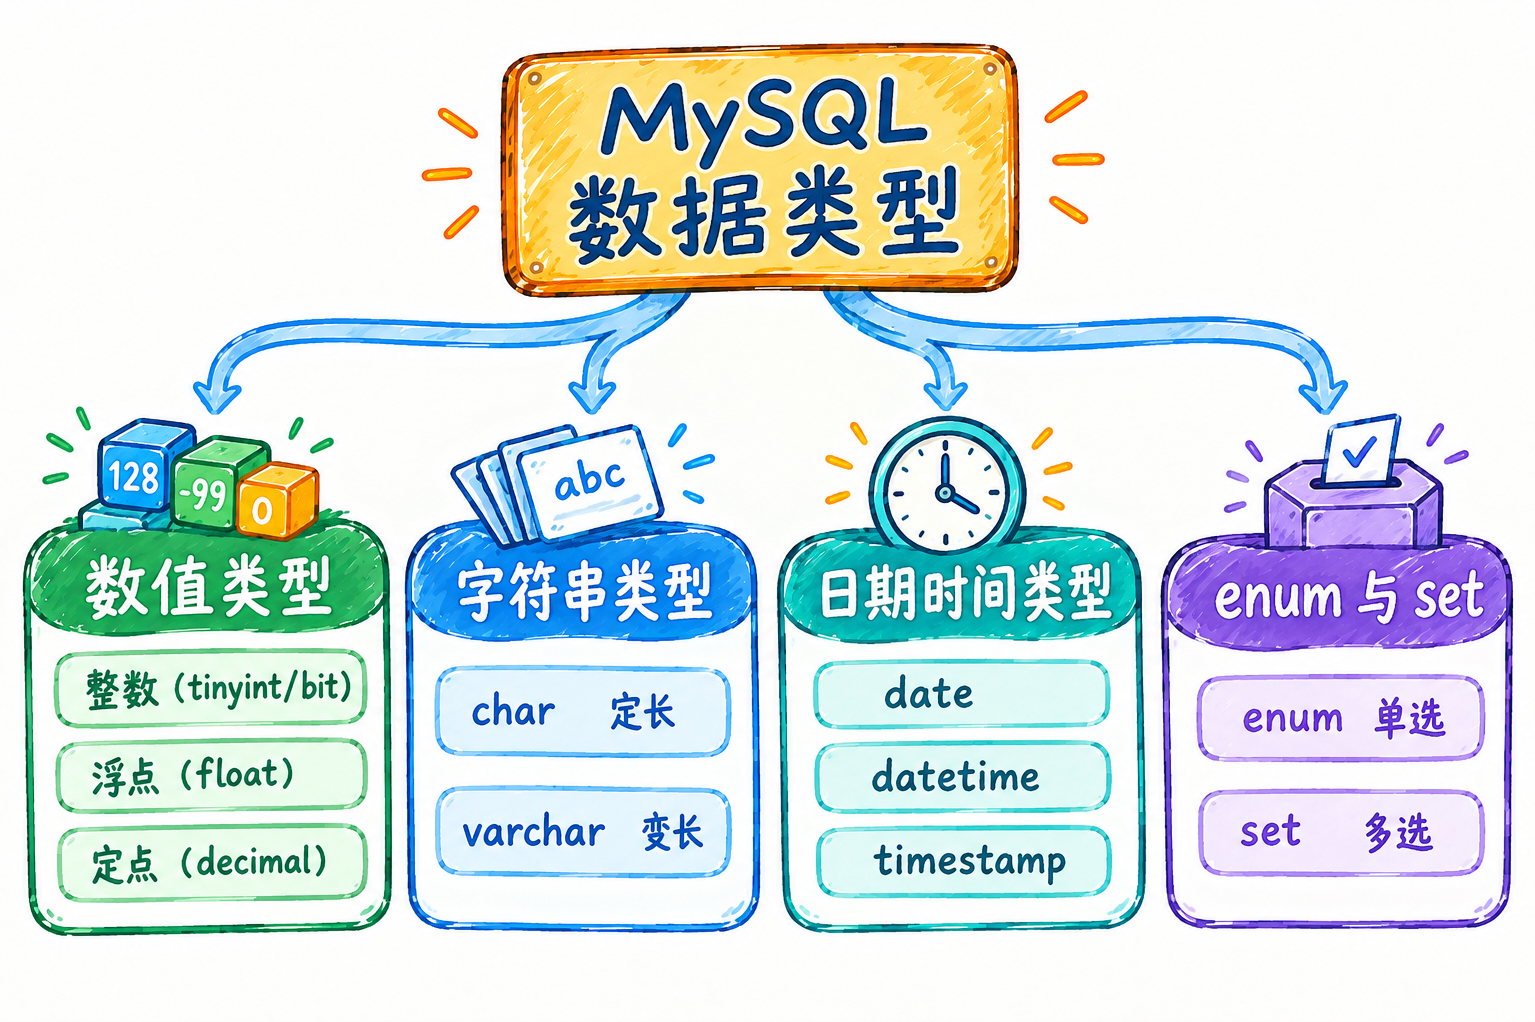
从这里我们可以看到,在 SQL 中存储数据跟在 C/C++、Java 里很相似——都需要先声明类型。数据库之所以必须预先知道每一列的数据"长什么样",是因为要:
- 分配固定的存储空间:知道一列是 int(4 字节)还是 bigint(8 字节),才能在磁盘上为每条记录划分出整齐划一的空间,实现 O(1) 的按偏移量定位。如果每行数据长短不一、类型混乱,查询时就得逐字节解析,性能直接崩盘。
- 确定取值范围,防止脏数据:类型天然是一道"数据质检关卡"。定义成 tinyint,就杜绝了别人往里面塞一个 999999;定义成 date,就杜绝了塞进 “abc”。数据库在写入那一刻就帮你拦下非法数据,而不是等业务逻辑跑挂了才发现。
- 决定比较与排序的规则:同样是"字符串",utf8_bin 和 utf8_general_ci 比大小结果完全不同;同样是"数字",int 按数值比、varchar 按字典序比。类型决定了 where、order by、group by 的行为。
数据类型是数据库里"存储空间、取值范围、比较规则"三者的统一契约。 你在建表时写的每一个类型,本质上都是在和 MySQL 签订一份约束协议——告诉它这一列数据能长多大、能装多少、该怎么比。协议签得好,后面省心;签得马虎,后面处处是坑。
1.1 四大类型总览
这是覆盖 MySQL 最常用的四大类型家族,各自解决一类"存什么"的问题:
| 类型 | 代表类型 | 解决的核心问题 | 一句话记忆 |
|---|---|---|---|
| 数值类型 | tinyint、bit、float、decimal | 存整数、小数、位 | “数字怎么存才不越界、不丢精度” |
| 字符串类型 | char、varchar | 存文本 | “定长还是变长,这是个问题” |
| 日期时间类型 | date、datetime、timestamp | 存时间 | “年月日、时分秒、自动时间戳” |
| enum 与 set | enum、set | 存有限选项 | “单选用 enum,多选用 set” |
严格来说,MySQL 官方的类型分类里还有二进制类型(binary、varbinary、blob)和 JSON 类型等,但本讲聚焦最常用、也是面试和开发中最容易出错的这四类。掌握了它们,就覆盖了日常 95% 以上的建表场景。
下面这张表具体展示了 MySQL 常用类型的说明:
| 数据类型 | 说明 |
|---|---|
| BIT(M) | 位类型。M 指定位数,默认值 1,取值范围 1-64 |
| TINYINT [UNSIGNED] | 带符号的范围 -128 ~ 127,无符号范围 0 ~ 255。默认有符号 |
| BOOL | 底层本质是 TINYINT,使用 0 和 1 表示假和真 |
| SMALLINT [UNSIGNED] | 带符号:-215 ~ 215-1;无符号:0 ~ 216-1 |
| INT [UNSIGNED] | 带符号:-231 ~ 231-1;无符号:0 ~ 232-1 |
| BIGINT [UNSIGNED] | 带符号:-263 ~ 263-1;无符号:0 ~ 264-1 |
| FLOAT [(M,D)] [UNSIGNED] | M 表示有效总位数,D 指定小数位数;占用 4 字节;MySQL 8.0.17 起废弃显示宽度写法 |
| DOUBLE[(M,D)] [UNSIGNED] | 双精度浮点数,精度高于 float;占用 8 字节;MySQL 8.0.17 起废弃显示宽度写法 |
| DECIMAL(M,D) [UNSIGNED] | 定点数;M 指定数字总位数,D 表示小数点后的位数,用于高精度小数存储(金额等) |
| CHAR(SIZE) | 固定长度字符串;size 单位是字符,最大 255 字符 |
| VARCHAR(SIZE) | 可变长度字符串;单行最大行限制 65535 字节;实际可存字符数量受字符集影响(utf8 下字符数小于 65535) |
| BLOB | 二进制类型,用于存放二进制数据(图片、文件二进制流) |
| TEXT | 大文本;支持 FULLTEXT 全文索引;MySQL 8.0.13 之前不允许设置默认值,之后支持表达式形式默认值 |
| DATE | 日期类型,格式 yyyy-mm-dd,范围 1000-01-01 ~ 9999-12-31 |
| DATETIME | 日期 + 时间,格式 yyyy-mm-dd hh:mm:ss,范围 1000-01-01 00:00:00 ~ 9999-12-31 23:59:59,不随时区变化 |
| TIMESTAMP | 时间戳类型,存储 UTC 时间,会随会话时区自动换算显示;范围 1970-01-01 ~ 2038-01-19(受 32 位限制) |
| ENUM 类型 | 枚举字符串对象;列的值只能选取建表时预先定义好的其中一个值;底层存储整数序号 |
| SET 类型 | 集合字符串对象,可以选取 0 个或者多个预先定义的值;多个值之间使用逗号分隔;集合成员的值本身不能包含逗号;底层使用位图整数存储 |
下面,我们按"从易到难、从整数到选择"的顺序,逐个拆解。
二、数值类型
数值类型分为两大类:整数类型和小数类型,它们之间有很多相似之处,下面就让我们来了解它们。
2.1 整数类型:tinyint、unsigned 与 bit——别让数据"越界"
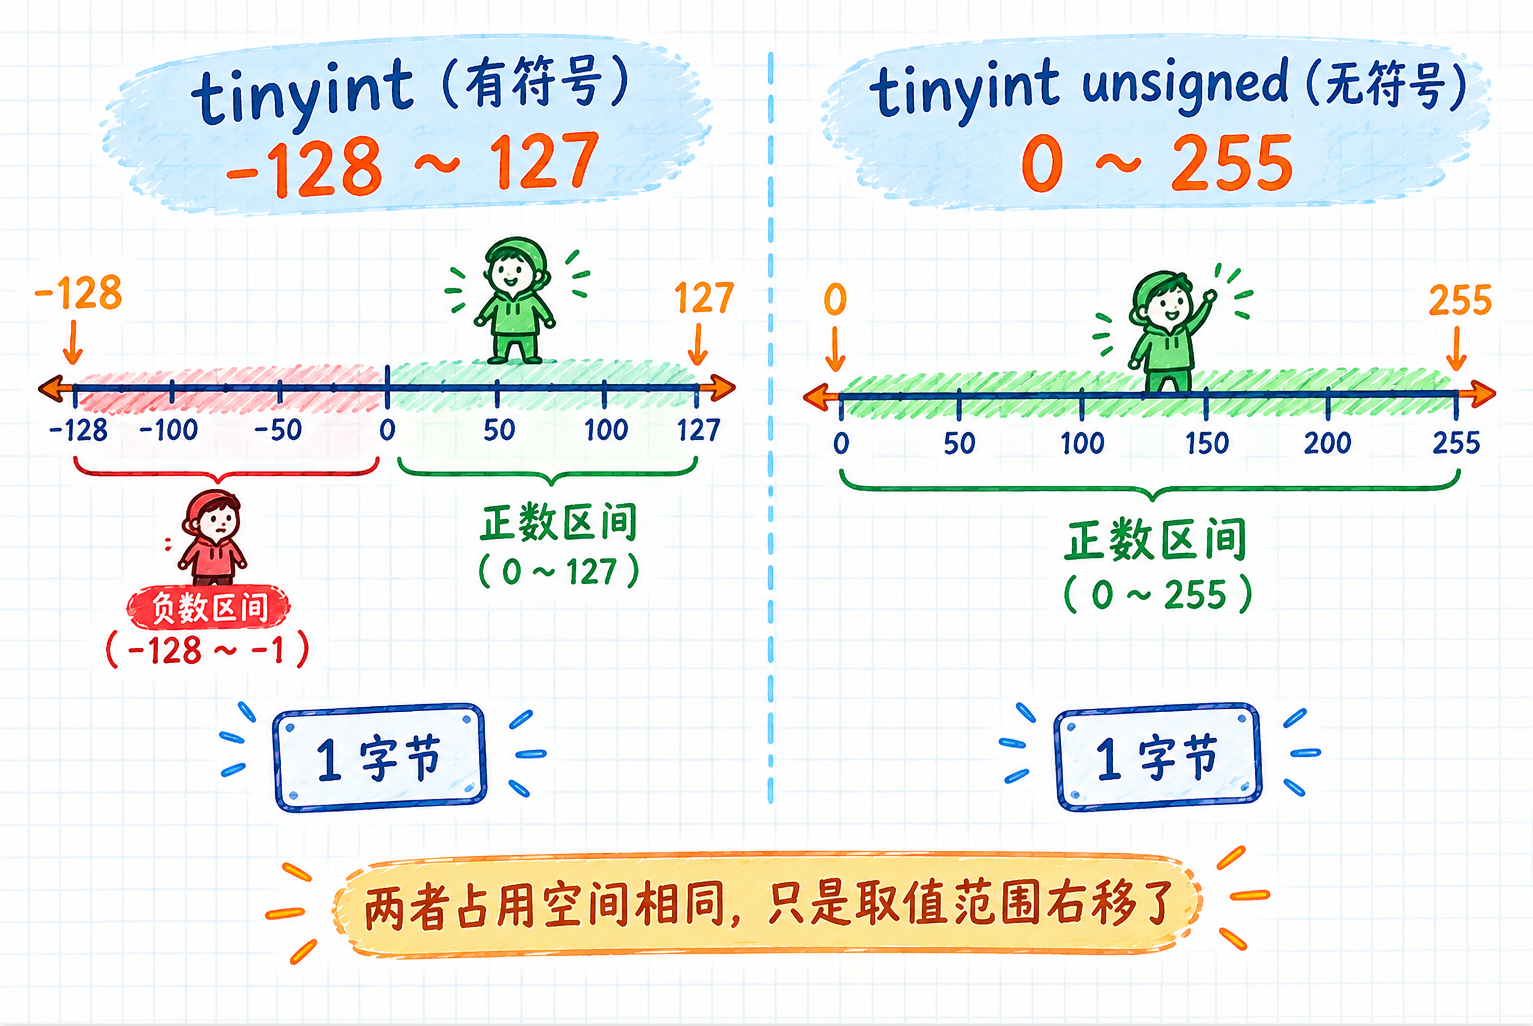
整数是最基础、用得最多的类型。但恰恰是因为它的"简单",很多人反而栽在它身上——越界。要理解越界,得先理解"有符号"和"无符号"这对概念。
##### 2.1.1 tinyint:一字节的"小整数"
tinyint 是最小的整数类型,只占 1 个字节(8 bit)。8 个比特位能表示的组合是 2^8 = 256 种,所以 tinyint 的取值范围根据有无符号分为两种:
- 有符号(默认):用最高位表示正负号,剩下 7 位表示数值,所以范围是 -128 ~ 127。
- 无符号(unsigned):不用考虑正负,8 位全用来表示数值,范围是 0 ~ 255。
关键点来了:tinyint 默认是有符号的。你写 create table t(num tinyint),得到的是一列"只能存 -128~127"的整数,而不是 0~255。
-- 默认有符号,范围 -128 ~ 127
create table t1(id tinyint);

insert into t1 values(127);   -- OK,127 在范围内
insert into t1 values(128);   -- 越界!报错
验证结果(MySQL 8.0.36):
| 语句 | 执行结果 |
|---|---|
| insert into t1 values(127); | Query OK, 1 row affected |
| insert into t1 values(128); | ERROR 1264 (22003): Out of range value for column 'id' at row 1 |
Out of range——超出范围。这是初学者第一次接触 MySQL 时最常看到的报错之一,它的含义非常直白:你要塞进去的值,超过了这一列类型能容纳的边界。注意报错里带了三样东西:错误码 1264、SQLSTATE 22003、出错的列名,排查时先看列名,再看错误码。
因为 tinyint 默认有符号,8 个比特位中只有 7 位能表达数值,所以有符号 tinyint 的最大值只有 127。
bool 类型其实是 tinyint 的别名,它们的大小都是一字节。
##### 2.1.2 有符号与无符号:UNSIGNED 关键字
如果你确定这一列永远不可能是负数(比如年龄、数量、库存),可以用 unsigned 关键字把它声明为无符号,把负半轴的空间"平移"到正半轴,从而让正数范围翻一倍:
-- 无符号,范围 0 ~ 255
create table t2(num tinyint unsigned);

insert into t2 values(-1);    -- 越界!无符号不允许负数
insert into t2 values(255);   -- OK,255 是上限
insert into t2 values(256);   -- 越界,255 是上限
验证结果:
| 语句 | 执行结果 |
|---|---|
| insert into t2 values(-1); | ERROR 1264 (22003): Out of range value for column 'num' at row 1 |
| insert into t2 values(255); | Query OK, 1 row affected |
| insert into t2 values(256); | ERROR 1264 (22003): Out of range value for column 'num' at row 1 |
可以看到,当我们把 tinyint 设置为无符号时,它能存储的数据范围就变成了 0~255。
一个重要的工程建议:尽量少用 unsigned。 原因很实在——如果你的 int 都快存不下了,int unsigned 同样存不下(它只是把范围平移,总量没变);与其纠结正负号,不如在设计时直接把类型升级成 bigint,一劳永逸。unsigned 还会带来一个隐蔽的坑:有符号列和无符号列做运算时可能触发隐式类型转换,导致意想不到的结果。所以除非有明确的"非负"业务约束,否则保持默认有符号即可。
##### 2.1.3 其他整数类型
tinyint 是存一字节的小整数,除了它,还有我们常用的 int、bigint 等,用法与 tinyint 相似,只是存储的大小不同:
| 类型 | 字节数 |
|---|---|
| TINYINT | 1 字节 |
| SMALLINT | 2 字节 |
| MEDIUMINT | 3 字节 |
| INT / INTEGER | 4 字节 |
| BIGINT | 8 字节 |
根据存储的大小不同,它们所能存储的数据范围也就不同,但符号位的规则是一样的:有符号时最高位表示符号,剩下 7 位表示数值;无符号时所有位数都表示数值。
这些整数类型(tinyint、smallint、int、bigint)的越界行为完全一致,只是取值范围不同,我们可以自己推导:int 占 4 字节(有符号约 ±21 亿),bigint 占 8 字节(约 ±922 亿亿)。理解了 tinyint 的原理,其余的都是"换了个更大的格子",本质不变。
##### 2.1.4 bit 类型:按位存储的"位字段"
bit 是一个容易被忽略、但很有意思的类型。它的语法是:
bit[(M)] -- M 表示每个值的位数,范围 1~64,省略则默认 1bit(M) 存储的是二进制位,而不是我们习惯的十进制整数。当 M=8 时,它可以存 0 ~ 2^8-1(即 0~255)的整数:
create table t3 (id int, a bit(8));
insert into t3 values(1, 10);   -- 存了 10
insert into t3 values(2, 60);   -- 存了 60

select id, a, hex(a), a+0 from t3;
验证结果:
| id | a(直接查) | hex(a) | a+0 |
|---|---|---|---|
| 1 | 二进制串(Navicat 显示为 0x0A) | 0A | 10 |
| 2 | 二进制串(Navicat 显示为 0x3C) | 3C | 60 |
可以看到,虽然 bit 存储的是二进制位,但我们插入时可以直接写十进制或十六进制,MySQL 在写入时会自动转换,前提是不能越界;而查询时它返回的是二进制串,想拿回十进制数字需要 +0 或 hex()。
bit(M) 用于存储一组二进制位(位掩码),适合在一个字段里保存多个开关标识。
下面看一下 bit 越界的情况:
create table t4(gender bit(1));
insert into t4 values(0);   -- OK
insert into t4 values(1);   -- OK
insert into t4 values(2);   -- 越界!bit(1) 只能存 0 或 1
验证结果:
| 语句 | 执行结果 |
|---|---|
| insert into t4 values(0); | Query OK |
| insert into t4 values(1); | Query OK |
| insert into t4 values(2); | ERROR 1406 (22001): Data too long for column 'gender' at row 1 |
注意报错信息的区别:整数越界报的是 Out of range(超出范围,错误码 1264),而 bit(1) 塞 2 报的是 Data too long(数据太长,错误码 1406)。这是因为 bit(1) 只有 1 个二进制位,2 的二进制是 10,两个位,塞不进 1 个位里,所以是"太长"而不是"超范围"。
理解了这两个错误码的区别,整数范畴内的越界问题就基本能对症下药了。
2.2 小数类型:float 与 decimal 的精度之争
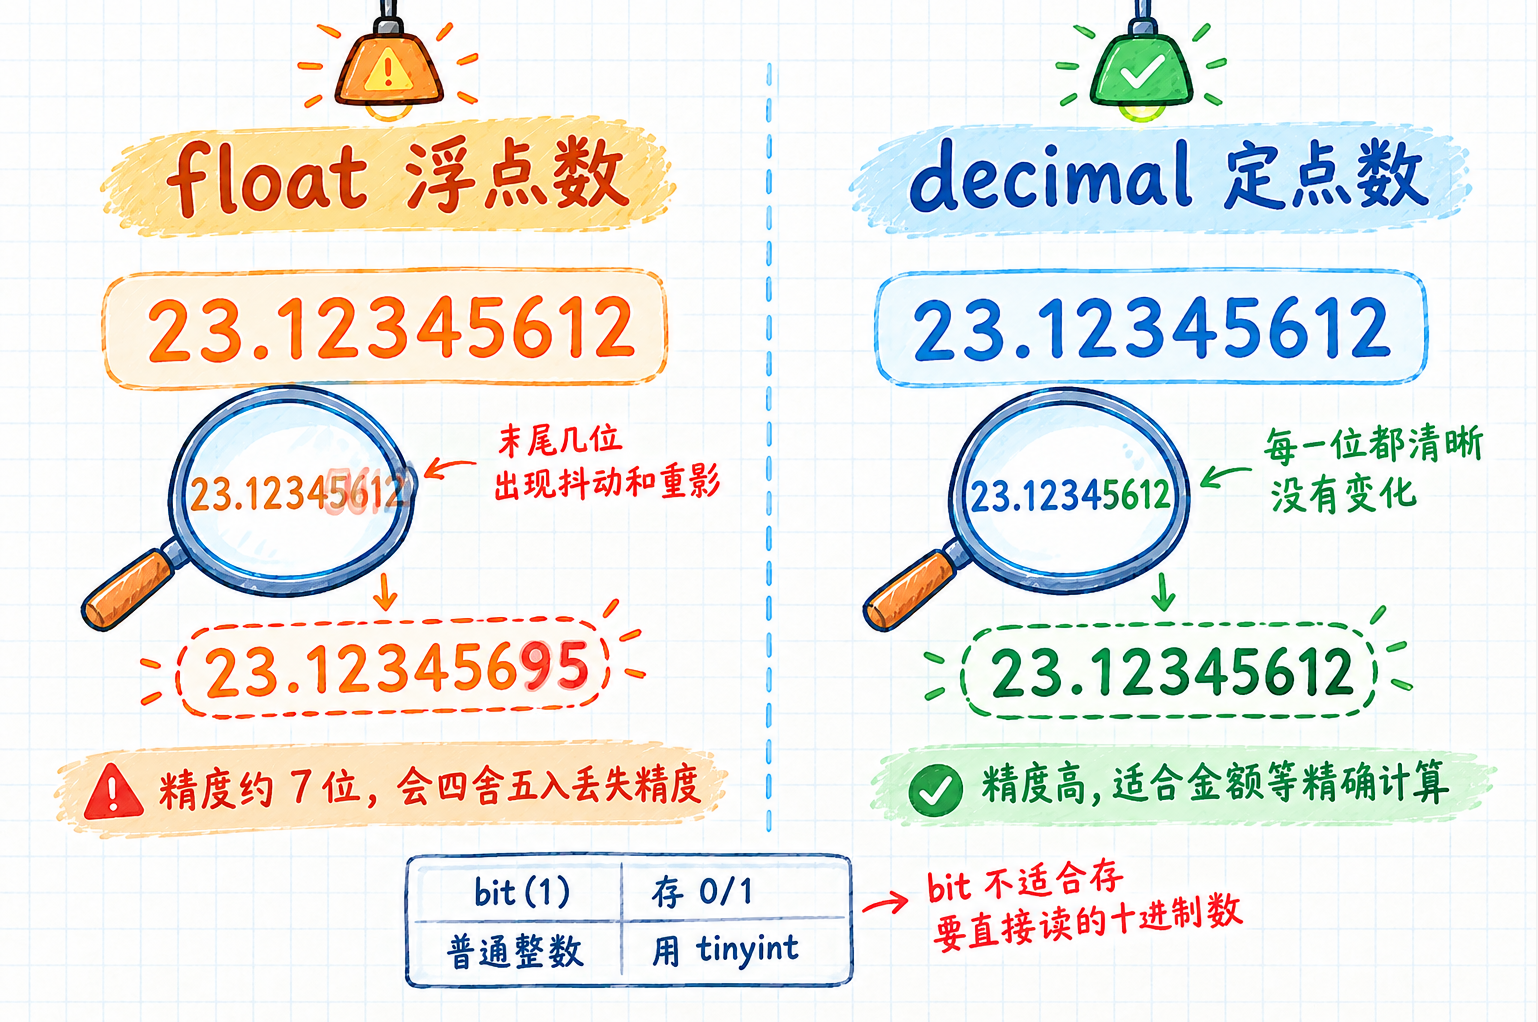
实际开发中,存钱、存价格、存比例……各种小数无处不在,所以我们需要有类型来存储小数。MySQL 提供了 float、double 和 decimal 三种类型,但小数的存储里藏着一个经典陷阱:float、double 存进去的数字,取出来可能会变样。这是由浮点数的性质决定的,而不是 bug。
##### 2.2.1 float:浮点数与"四舍五入"
float 有一个特殊的语法:
float[(m, d)] [unsigned] -- m 指定显示长度,d 指定小数位数,共占 4 字节其中 m 是总位数(整数部分 + 小数部分),d 是小数位数。比如 float(4,2) 表示"总共 4 位、小数点后有 2 位",于是整数部分最多 2 位,范围是 -99.99 ~ 99.99。如果定义成 float(6,3),那就是总共 6 位、小数 3 位,范围是 -999.999 ~ 999.999——这是 float 的语法规定。
float(m, d) 在查看时有一个关键行为:四舍五入。我们看下面的例子:
create table t5(id int, salary float(4,2));
insert into t5 values(100, -99.99);
insert into t5 values(101, -99.991);
select * from t5;
验证结果:
| id | salary |
|---|---|
| 100 | -99.99 |
| 101 | -99.99 |
存储时 -99.991 有三位小数,但列只允许 2 位,所以查询时 MySQL 把它四舍五入成了 -99.99(多出的第三位 1 被舍去)。这是 float(m,d) 的"定点化"约束在起作用——这个约束只作用在显示上,内部存储并不会四舍五入。
unsigned 对小数同样生效:float(4,2) unsigned 的范围是 0 ~ 99.99(负数被禁止)。
float 的大小是 4 字节,double 是 8 字节,用法一样,就跟 int 和 bigint 的区别一样。除了内存大小,它们在存储精度方面也不同:
- float:最多保证前面 6-7 位数字是准确的;例如 123456.7 还勉强,1234567.8 后面就开始失真。
- double:保证 15-16 位有效数字;位数很长时依旧会丢精度。
注意:MySQL 写法 float(M,D)、double(M,D) 是非标准扩展,MySQL 8.0.17 起已废弃,建议直接写 float / double。它只是显示约束,不能消除浮点误差。
因为精度丢失的问题,十进制小数无法完整转为二进制,所以 float 不能做等值查询,只能做范围比较。
这里有个流传很广的误区,必须澄清:很多教材写 select 0.1 + 0.2; 会得到 0.30000000000000004,但在 MySQL 里这条语句返回的是 0.3——因为 0.1、0.2 这种带小数点的字面量是 DECIMAL 类型,参与运算时走的是精确十进制运算。
要复现浮点误差,必须让值真正落进 float / double 列,或者使用科学计数法字面量:
-- 方式一:值真正存进 float 列
create table t_f(a float, b float);
insert into t_f values(0.1, 0.2);
select a + b        from t_f;   -- 0.30000001192092896
select a + b = 0.3  from t_f;   -- 0

-- 方式二:科学计数法字面量按 DOUBLE 处理
select 0.1e0 + 0.2e0;           -- 0.30000000000000004
验证结果:
| 语句 | 结果 | 说明 |
|---|---|---|
| select 0.1 + 0.2; | 0.3 | DECIMAL 精确运算,不丢精度 |
| select 0.1e0 + 0.2e0; | 0.30000000000000004 | DOUBLE 运算,出现误差 |
| select a + b from t_f; | 0.30000001192092896 | float 列相加,误差被放大 |
| select a + b = 0.3 from t_f; | 0 | 等值比较失败 |
十进制有限小数,保存之后内部变成一个无限循环二进制,只能截取保存,于是产生误差。这也是金额字段绝对不能用 float 的根本原因——单条看不出来,累加就会露馅(真实案例见第六章)。
##### 2.2.2 decimal:定点数,为精确而生
上面说了最经典的存小数的类型 float,但存 float 时存在固有精度丢失、无法保证数值准确的问题,在面对需要高精度小数的场景下使用 float 会产生无法预估的错误,所以就有了 decimal 类型:
- DECIMAL(M,D) 定点数,精确数值类型,专门用来解决 float/double 二进制浮点的精度丢失问题。
decimal 底层存储是十进制,不是二进制浮点数。常用于财务、金额、单价。
decimal(m, d) [unsigned] -- 定点数,m 指定长度,d 指定小数位数例如 decimal(5,2) 的范围是 -999.99 ~ 999.99(整数部分 3 位 + 小数 2 位)。它的参数上限更宽:整数最大位数 m 最大 65,小数位数 d 最大 30。如果省略 d 默认 0(即存整数),省略 m 默认 10。
如果省略 M,D 直接写 DECIMAL,默认等价 DECIMAL(10,0),也就是整数。
decimal 不是简单一个数字占一个字节;在 MySQL 规则中:每 9 位十进制数字占用 4 个字节;剩余不足 9 位的部分按下表分配:
| 剩余数字个数 | 占用字节 |
|---|---|
| 1-2 位 | 1 字节 |
| 3-4 位 | 2 字节 |
| 5-6 位 | 3 字节 |
| 7-9 位 | 4 字节 |
举例:DECIMAL(10,2),总共 10 位数字 = 9 位 + 1 位 → 4 字节 + 1 字节 = 总共 5 字节。
对比 float 固定 4 字节、double 固定 8 字节;decimal 存储空间是可变的。
decimal 和 float 长得很像,但底层原理完全不同:
- float 用 IEEE 754 浮点数格式存储,是二进制的近似表示;
- decimal 用字符串、定点方式存储,每一位十进制数字都被精确保存。
这就导致了著名的精度差异:
create table t6 (id int, salary float(10,8), salary2 decimal(10,8));
insert into t6 values(100, 23.12345612, 23.12345612);
select * from t6;
验证结果:
| id | salary(float) | salary2(decimal) |
|---|---|---|
| 100 | 23.12345695 | 23.12345612 |
同样的值 23.12345612 存进两个列,float 那一列变成了 23.12345695(末尾几位已经失真),而 decimal 那一列分毫不差。
为什么会这样?float 的有效精度大约只有 7 位。23.12345612 一共 10 位有效数字,超出了 7 位的承载能力,于是二进制转换时产生了无法避免的舍入误差。而 decimal 是逐位存储的定点数,不涉及二进制转换,所以精确无损。
如果需要高精度的小数——尤其是金额、账户余额这类"一分钱都不能差"的数据——一定要用 decimal。金额用 float 存的后果是灾难性的:0.1 元可能变成 0.09999999 元,几十万条记录累加下来,账就对不上了。
同时,decimal 在插入数据的时候就直接做四舍五入,然后把舍入之后的值存入磁盘;底层保存的就是舍入之后的值。
create table t7(salary decimal(5,2));
insert into t7 values(123.456);   -- 注意:会触发 Note 1265,但插入成功
select * from t7;
select salary, salary + 0 from t7;
验证结果:
| 语句 | 结果 |
|---|---|
| insert into t7 values(123.456); | Query OK, 1 row affected, 1 warning (Note 1265: Data truncated for column 'salary') |
| select * from t7; | 123.46 |
| select salary + 0 from t7; | 123.46 |
插入 123.456,写入时四舍五入保存 123.46。之后不管是直接 select,还是 select salary+0,拿出来都是 123.46。而 float(M,D) 是在底层存原始近似值,仅仅 select 展示的时候才四舍五入。这是两者一个重要的区别:
- float(M,D):先存,展示修整;
- decimal(M,D):先修整,再存储。
如果插入数字的整数部分超过 M-D 允许的位数,直接报溢出错误,拒绝写入(严格 SQL 模式),不会默默失真。
而 float 是悄无声息把大数改写成近似值,不报错。
我们来看一下 float 和 decimal 的对比:
| 对比维度 | float | decimal |
|---|---|---|
| 存储方式 | 二进制浮点数(IEEE 754) | 定点数,逐位存储 |
| 有效精度 | 约 7 位 | m 最大 65 位,完全精确 |
| 占用空间 | 固定 4 字节 | 随位数变化(约每 9 位 4 字节) |
| 存储速度 | 快(CPU 有浮点硬件加速) | 稍慢(需软件处理) |
| 精度 | 有舍入误差 | 无误差 |
| 适用场景 | 科学计算、允许微小误差的统计 | 金额、价格、账户余额 |
简单来说:精度要求不高、追求速度用 float;精度就是生命线(尤其和钱相关)用 decimal。在绝大多数业务系统里,钱相关字段几乎都是 decimal 的天下。
三、字符串类型:char 与 varchar 的定长与变长
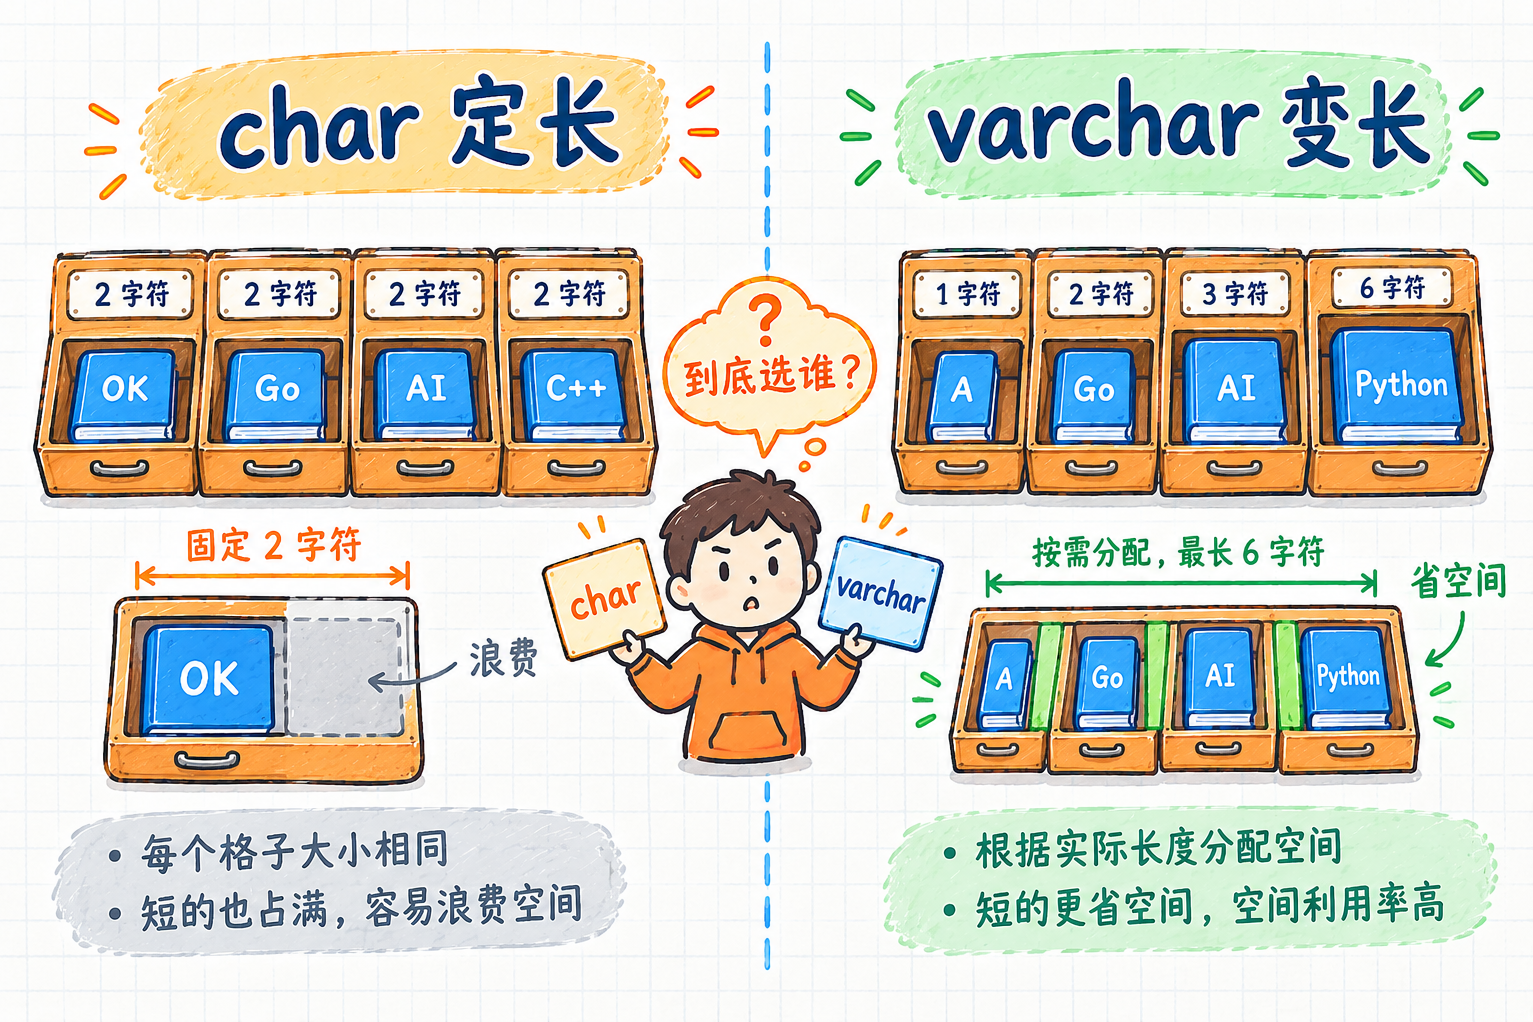
存名字、存地址、存密码……字符串是日常开发中碰得最多的类型。它只有两个主角——char 和 varchar,它们的区别就在于"定长 vs 变长"的选择,而这个选择会影响你的磁盘空间和查询性能。
要正确地在不同场景下选择 char 和 varchar,我们只需要理解定长和变长的区别即可:
- 定长:固定长度的字符串,无论你实际存多少,它都固定占指定字符的空间;
- 变长:可变长度的字符串,用多少、存多少,实际占用空间随内容长度变化。
3.1 char:定长字符串
char 的使用:
char(L) -- 固定长度字符串,L 单位是字符,最大 255char(L) 的"定长"意味着:无论你实际存多少,它都固定占 L 个字符的空间。 存 1 个字符也占 L 个字符的位置,不足的部分用空格填充(取出时会自动去掉尾部空格)。
下面先试一下用 char 存储字符串:
create table t8( id int, addr char(2) );
insert into t8 values (1, 'ab');
insert into t8 values (2, '中国');
select * from t8;
验证结果:
| id | addr |
|---|---|
| 1 | ab |
| 2 | 中国 |
注意一个细节:char(2) 的 2 是"字符"而不是"字节"。所以它既能存 2 个英文字母 ab,也能存 2 个汉字 中国(每个汉字在 utf8mb4 下占 3 字节,但按字符算仍是 1 个)。这是 MySQL 字符串类型和很多其他语言的一个关键差异。
如果字符串的字符数大于我们规定的字符数,会根据 sql_mode 产生不同的行为:
- 严格模式:直接报错,插入失败,Data too long for column 'xxx';
- 非严格模式:截断后面多余字符,产生告警,允许写入。
我们来超过最大字符限制看看会发生什么:
insert into t8 values (3, 'abc');验证结果:
| 语句 | 结果 |
|---|---|
| insert into t8 values (3, 'abc'); | ERROR 1406 (22001): Data too long for column 'addr' at row 1 |
报错说明当前处于严格模式,可以用 select @@sql_mode; 查看当前会话的 sql_mode:
select @@sql_mode;
-- STRICT_TRANS_TABLES,NO_ZERO_IN_DATE,NO_ZERO_DATE,ERROR_FOR_DIVISION_BY_ZERO,NO_ENGINE_SUBSTITUTION
一般 MySQL 都会默认开启严格模式 STRICT_TRANS_TABLES,最好不要随便修改——关闭它的直接后果就是脏数据被静默截断写入。
接下来是一个容易被忽略的细节:char 末尾的空格会被丢弃。
create table t9(id int, str char(6));
insert into t9 values (1, 'abc  ');   -- 2 个空格
insert into t9 values (2, 'abc');
select * from t9;
select * from t9 where str = 'abc';
验证结果:
| 语句 | 结果 |
|---|---|
| select * from t9; | 两行都显示 abc |
| select * from t9 where str = 'abc'; | 两行都被查出来 |
'abc ' 和 'abc' 在 char(6) 里被认为是相等的——char 在存储时会直接把字符串末尾的空格截掉。
那如果"内容 + 末尾空格"的总长度超过 L 呢?
insert into t9 values (3, 'abc   ');    -- 3 个空格,共 6 字符
insert into t9 values (4, 'abc    ');   -- 4 个空格,共 7 字符
insert into t9 values (5, 'abc     ');  -- 5 个空格,共 8 字符
验证结果:
| 语句 | 结果 |
|---|---|
| insert into t9 values (3, 'abc '); | Query OK |
| insert into t9 values (4, 'abc '); | Query OK,末尾空格被截断 |
| insert into t9 values (5, 'abc '); | Query OK,末尾空格被截断 |
关键点:MySQL 会先把末尾空格截断,再判断长度,所以用 char 存储时,实际长度是"舍去末尾空格后的长度"。这也意味着 char 永远不会因为"末尾多了几个空格"而报 Data too long。
最后,char 的长度上限是 255 字符,试着超过它:
create table t10(id int, name char(256));验证结果:
| 语句 | 结果 |
|---|---|
| create table t10(id int, name char(256)); | ERROR 1074 (42000): Column length too big for column 'name' (max = 255); use BLOB or TEXT instead |
报错信息很贴心——它甚至告诉你"该用 BLOB 或 TEXT 了"。char 只能存短定长文本,真正的"长文本"要交给 TEXT 或 BLOB。
3.2 varchar:变长字符串
varchar 的使用:
varchar(L) -- 可变长度字符串,L 单位是字符,最大 65535 字节varchar(L) 的"变长"意味着:用多少、存多少,实际占用空间随内容长度变化。 它只在你塞进的数据不超过 L 的前提下,按实际长度分配空间。
create table t11(id int, str varchar(2));
insert into t11 values (1, 'ab');
insert into t11 values (2, '中国');
insert into t11 values (3, 'abc');
select * from t11;
验证结果:
| 语句 | 结果 |
|---|---|
| insert into t11 values (1, 'ab'); | Query OK |
| insert into t11 values (2, '中国'); | Query OK |
| insert into t11 values (3, 'abc'); | ERROR 1406 (22001): Data too long for column 'str' at row 1 |
在简单场景下,char 和 varchar 的写入结果基本一致,超限时的行为也只跟 sql_mode 有关。那它们的不同点到底在哪?主要两个方面:
- 末尾空格的处理
- varchar 的最大长度
先看末尾空格。上面我们知道了 char 会截断末尾空格,而 varchar 不会:
create table t12(id int, str varchar(6));
insert into t12 values (1, 'abc  ');    -- 2 个空格,共 5 字符
insert into t12 values (2, 'abc   ');   -- 3 个空格,共 6 字符
insert into t12 values (3, 'abc    ');  -- 4 个空格,共 7 字符,超限
select str, length(str) from t12;
验证结果:
| id | str | length(str) | 说明 |
|---|---|---|---|
| 1 | abc | 5 | 正常保存尾部空格 |
| 2 | abc | 6 | 正好等于上限 |
| 3 | abc | 6 | 超出的 1 个空格被截断,插入成功 |
可以看到,varchar 正常情况下会保存尾部空格,但不能突破字段最大长度限制。这里有一条很特殊的规则:
对 VARCHAR 列,超过列长的尾部空格会在插入前被截断并产生警告,无论 sql_mode 是什么。 这与"普通字符超长"在严格模式下直接报错的行为是不同的。
也就是说,varchar(6) 遇到 'abc '(7 字符)不会报 Data too long,而是把多出来的空格切掉再存入。这和 char 的"末尾空格全部丢弃"是两回事:char 是丢弃,varchar 是保留但截到上限。
另一个不同点在于 varchar 的最大长度。char 的上限是 255 字符,而 varchar 是 65535 字节,但两者 L 的单位都是字符,这是为什么?
原因在于 varchar 是变长字符串:它需要用 1~2 字节记录数据本身的长度,所以实际能用的有效字节数是 65532。这样一来,varchar(L) 的 L 能取多大,就和表的字符集编码强相关了:
| 字符集 | 一个字符占的字节数 | varchar(n) 的 n 最大值 |
|---|---|---|
| utf8(3 字节/字符) | 3 | 65532 / 3 ≈ 21844 |
| gbk(2 字节/字符) | 2 | 65532 / 2 = 32766 |
| utf8mb4(4 字节/字符) | 4 | 65532 / 4 = 16383 |
可以用实验验证这个结论,先验证 utf8:
-- utf8 下,21845 个字符会超出 65535 字节的行大小限制
create table t13(name varchar(21845)) charset=utf8;
验证结果:
| 语句 | 结果 |
|---|---|
| create table t13(name varchar(21845)) charset=utf8; | ERROR 1118 (42000): Row size too large. The maximum row size for the used table type, not counting BLOBs, is 65535. |
再用 gbk 对比:
create table t13(name varchar(32767)) charset=gbk;   -- 会失败
create table t14(name varchar(32766)) charset=gbk;   -- 会成功
验证结果:
| 语句 | 结果 |
|---|---|
| create table t13(name varchar(32767)) charset=gbk; | ERROR 1118 (42000): Row size too large... |
| create table t14(name varchar(32766)) charset=gbk; | Query OK |
同样是 varchar(21845),在 gbk 下能建、在 utf8 下不能——因为 utf8 一个汉字要 3 字节,21845 × 3 = 65535 字节,正好撞上一行 65535 字节的天花板;而 gbk 一个汉字只要 2 字节,同样的字符数只占 4 万多字节,绰绰有余。
这说明:选字符集不只是"支不支持中文"的问题,还直接决定了字符串列能容纳的最大长度。
varchar 的 L 本身没有独立的语法上限,它受 MySQL Server 层"单行定义总字节上限 65535 字节"的约束;同理,char 的 255 字符上限也是 char 类型自身的语法限制。
MySQL 8 特别提醒:8.0 的默认字符集已经换成了 utf8mb4(每个字符最多 4 字节)。所以如果你建表时不显式写 charset,varchar(n) 的 n 上限其实是 65532 / 4 ≈ 16383,而不是上面 utf8 的 21844。另外,utf8 在 8.0 里只是 utf8mb3(3 字节)的别名,已被标记为废弃,生产环境更推荐直接用 utf8mb4。
3.3 char 与 varchar:如何选择
这是我们实际建表时的日常决策。先看两者的本质差异:
| 对比维度 | char(定长) | varchar(变长) |
|---|---|---|
| 存储空间 | 固定占满 L 字符,浪费空间 | 按实际长度分配,节省空间 |
| 存取效率 | 高(长度固定,定位快) | 低(需先读长度前缀,再定位) |
| 尾部空格 | 自动去除 | 保留 |
| 适用数据 | 长度固定的数据 | 长度不定的数据 |
那么到底该如何选择?可以记下面这条口诀:
- 数据长度确定、都一样 → 用 char。典型例子:身份证号、手机号、MD5 值。身份证永远是 18 位,MD5 永远是 32 位,用 char(18)、char(32) 最合适——定长带来的"定位快",让这类字段查询效率更高。
- 数据长度有变化 → 用 varchar。典型例子:姓名、地址、简介。有的人名字 2 个字,有的 4 个字;地址更是从"XX 市"到一长串门牌号。用 varchar 按需分配最省空间,但要保证最长的那个能存进去。
一句话总结定长与变长的设计哲学:定长的意义是"直接开辟好固定空间,用空间换时间";变长的意义是"在不超过上限的前提下,用多少开多少,用时间换空间"。 磁盘空间和存取效率是一对永恒的天平,char 偏向效率端,varchar 偏向空间端。绝大多数业务系统里,名字、地址这类字段用 varchar 是绝对主流,而身份证、MD5 这类"长度万年不变"的字段,用 char 更专业。
四、日期时间类型:date、datetime 与 timestamp
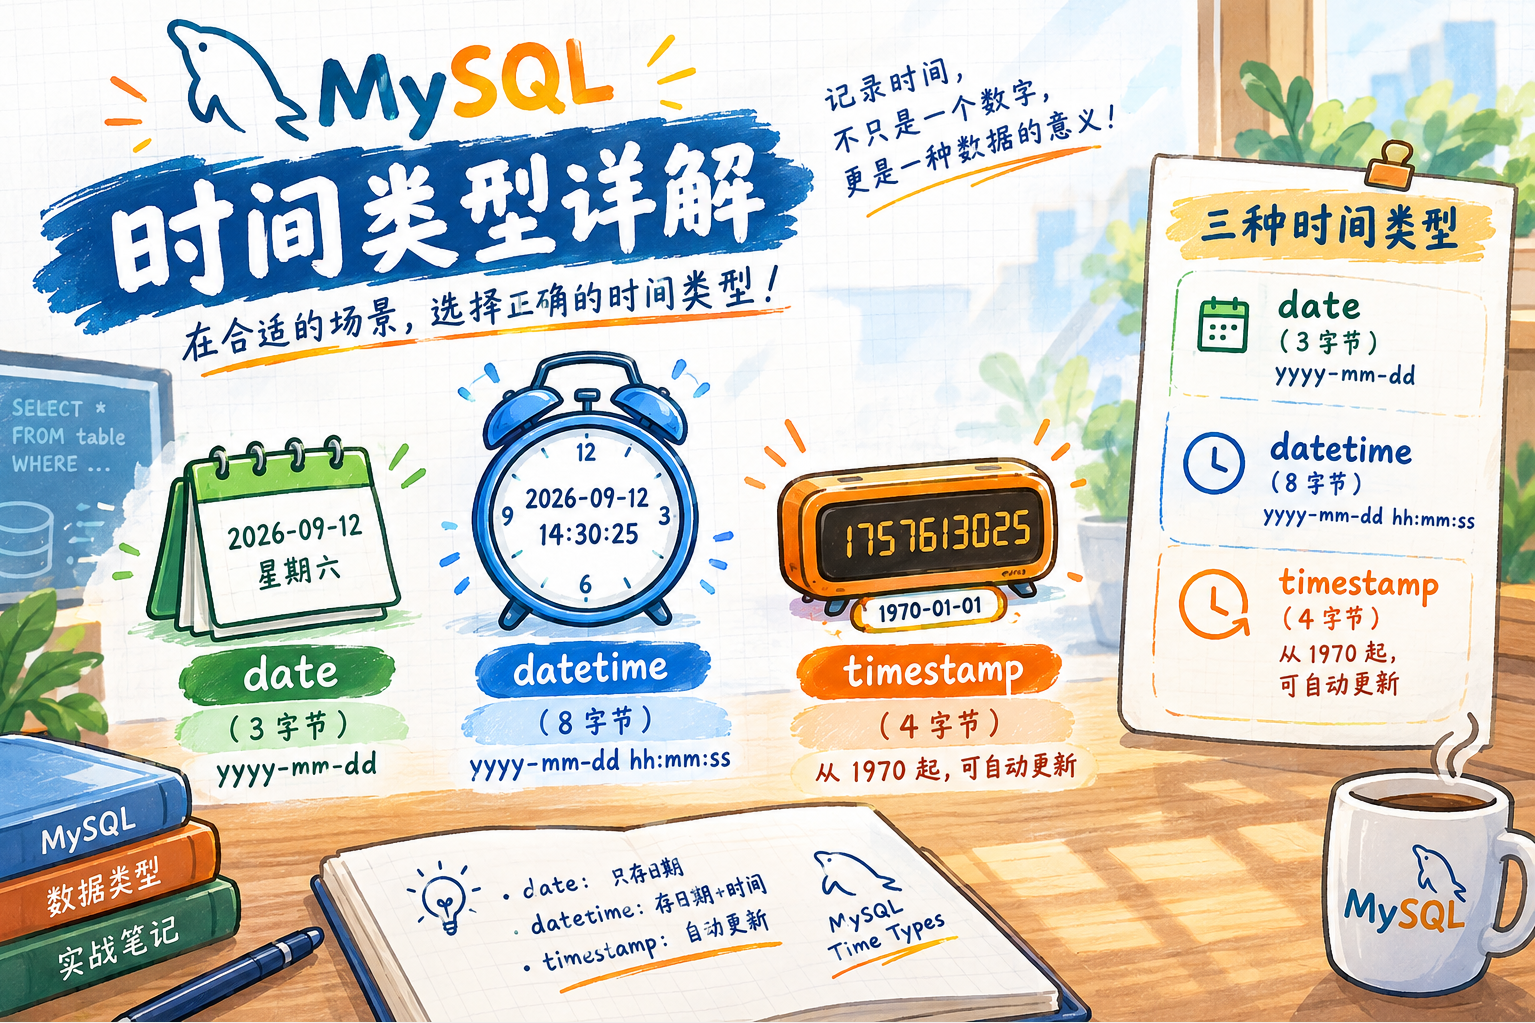
时间是业务数据里绕不开的一环:注册时间、下单时间、最后修改时间……MySQL 提供了三种常用的时间类型,它们各有分工。
4.1 三种时间类型一览
| 类型 | 格式 | 占用空间 | 取值范围 | 特点 |
|---|---|---|---|---|
| date | yyyy-mm-dd | 3 字节 | 1000-01-01 ~ 9999-12-31 | 只要年月日,如生日 |
| datetime | yyyy-mm-dd HH:ii:ss | 8 字节 | 1000-01-01 00:00:00 ~ 9999-12-31 23:59:59 | 精确到秒,范围大,不随系统时区变化 |
| timestamp | yyyy-mm-dd HH:ii:ss | 4 字节 | 1970-01-01 00:00:01 ~ 2038-01-19 03:14:07(UTC) | 时间戳,可自动更新为当前时间 |
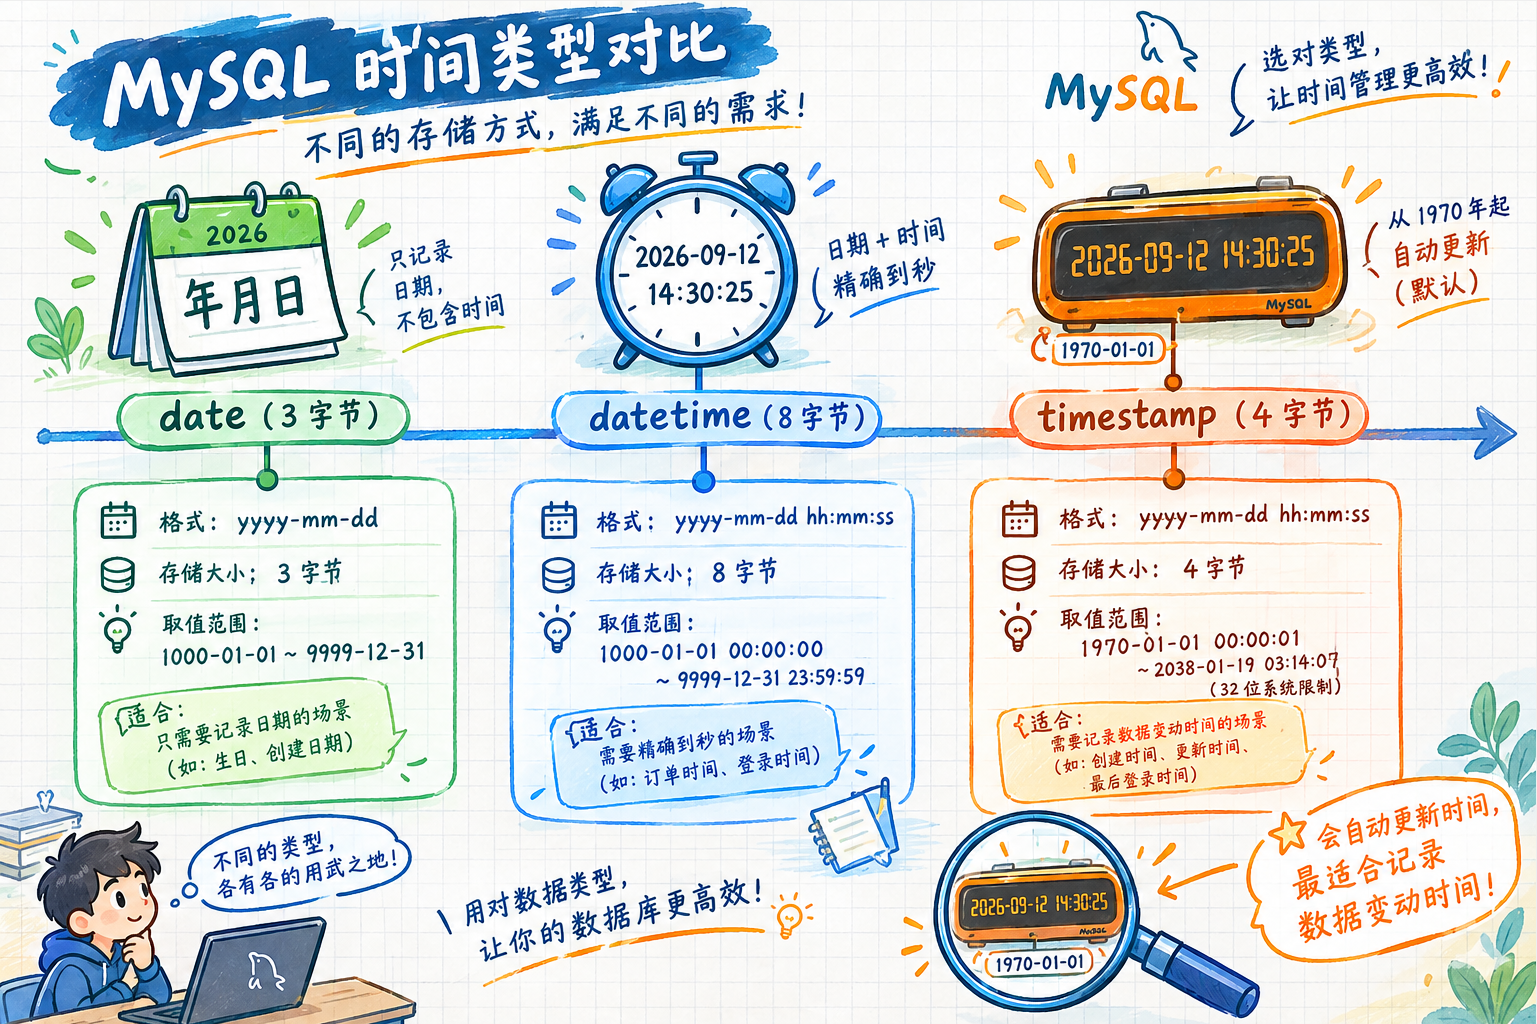
datetime 和 timestamp 的显示格式完全一样,都是 yyyy-mm-dd HH:ii:ss,但底层语义差别很大:
- datetime 就是字面意义上的"一个日期时间值",你存什么它显示什么,不依赖时区。
- timestamp 是"时间戳",内部存的是从 1970-01-01 00:00:00 UTC 起经过的秒数,显示时会转换成本地时区的时间。这也是它比 datetime 省一半空间(4 字节 vs 8 字节)的原因。
4.2 时间类型的格式与使用
光看表格不够直观,我们像前几节一样,先动手建一张表、插几条数据,亲眼看看这三种时间类型长什么样、对格式有什么要求。
-- 建表:三列分别用 date、datetime、timestamp
create table birthday (t1 date, t2 datetime, t3 timestamp);

-- 插入一条完整数据,三个时间字段都给值
insert into birthday(t1, t2, t3)
values('1997-7-1', '2008-8-8 12:1:1', '2008-8-8 12:1:1');

select * from birthday;
验证结果:
| t1(date) | t2(datetime) | t3(timestamp) |
|---|---|---|
| 1997-07-01 | 2008-08-08 12:01:01 | 2008-08-08 12:01:01 |
从这个结果能看出几个关于格式的细节:
- date 只要"年月日":插入 '1997-7-1',MySQL 自动把它规范化成标准格式 1997-07-01(月和日不足两位自动补 0)。
- datetime 要"年月日 + 时分秒":插入 '2008-8-8 12:1:1',显示时也补零成了 2008-08-08 12:01:01。
- timestamp 的格式和 datetime 一模一样,都是 yyyy-mm-dd HH:MM:SS——它俩长得完全一样,差别藏在底层存储里。
关于格式要求的几点提醒:
MySQL 对时间格式有一定宽容度——像上面 '1997-7-1'、'12:1:1' 这种不补零的写法也能识别,并自动规整成标准格式。但强烈建议严格按 yyyy-mm-dd 和 HH:MM:SS 写全,清晰、可读,也能避免不同版本解析差异带来的意外。时间字符串必须用引号括起来('1997-7-1'),因为它本质是字符串;忘了引号会被 MySQL 当成数字或表达式去解析,结果完全跑偏(下面 timestamp 的例子就是典型)。分钟这一位用大写的 MM(避免和月份 mm 混淆);有些老教材会把分钟写成 ii,两者含义相同,别被绕晕。
三种类型里,timestamp 的格式最容易让人困惑——它内部存的是秒数,对外却是时间字符串。围绕它有两个高频问题,一次说清。
问题一:能不能直接插 Unix 时间戳的秒数?
不能。虽然 timestamp 内部是"从 1970-01-01 起经过的秒数",但插入时要写时间字符串,而不是秒数。如果你硬插一个数字,MySQL 不会把它当"秒数",而是按"数字日期"的规则去解析——把数字当成 YYYYMMDDHHMMSS 来看,位数不对就报错:
insert into birthday (t3) values (1000); -- 不满足 14 位数字,插入失败验证结果:
| 语句 | 结果 |
|---|---|
| insert into birthday (t3) values (1000); | ERROR 1292 (22007): Incorrect datetime value: '1000' for column 't3' at row 1 |
如果是 14 位数字,那么该数字会被 MySQL 解析成时间:
insert into birthday (t3) values(20201001103000);   -- 14 位数字:YYYYMMDDHHMMSS
select * from birthday;
验证结果:
| 语句 | 结果 |
|---|---|
| insert into birthday (t3) values(20201001103000); | Query OK |
| 该行 t3 的值 | 2020-10-01 10:30:00 |
可以看到 20201001103000 被解读成了"2020 年 10 月 01 日 10 时 30 分 00 秒",而不是"从 1970 起经过了 20201001103000 秒"。如果你本意是塞一个 Unix 时间戳秒数,结果就完全跑偏了。
所以给 timestamp 赋值,一律用 'yyyy-mm-dd HH:MM:SS' 字符串,让 MySQL 自己去做"字符串 ↔ 秒数"的转换。真要按秒数写入,用 from_unixtime(1700000000)。
问题二:为什么显示出来是具体时间,而不是那串秒数?
因为 MySQL 在显示时会把你内部存的秒数自动换算成人类可读的 yyyy-mm-dd HH:MM:SS,并且套用当前会话的时区。你看到的"具体时间",其实是"内部秒数 + 时区换算"之后的结果。
这也解释了 timestamp 和 datetime 的关键区别:同一个 timestamp 值,在不同时区的服务器上会显示出不同的时刻(因为它是绝对秒数 + 本地时区翻译);而 datetime 没有这层换算,存什么就显示什么。
一句话总结 timestamp 的格式本质:存进去的是秒数,写出来、读出来的都是时间字符串——秒数对你是隐藏的,MySQL 在中间做翻译。
三种类型的标准格式如下,写 SQL 时最好严格按这个格式来:
| 类型 | 标准格式 | 含义 |
|---|---|---|
| date | yyyy-mm-dd | 年-月-日 |
| datetime | yyyy-mm-dd HH:MM:SS | 年-月-日 时:分:秒 |
| timestamp | yyyy-mm-dd HH:MM:SS | 格式同 datetime,内部存秒数 |
4.3 时间字段的自动更新
实际开发里,很多时间字段希望由数据库自动维护,而不是应用层每次手动赋值——比如"创建时间 create_time"、“最后修改时间 update_time”。这类字段一旦忘更新,数据就脏了;交给数据库自动处理,省心又不会漏。在 MySQL 中,datetime 和 timestamp 两种类型都可以进行自动更新。
在 MySQL 8 里,"自动更新时间"这个能力需要显式声明,这里以 datetime 为例:
create table orders (
    id int,
    create_time datetime default current_timestamp,
    update_time datetime default current_timestamp on update current_timestamp
);

insert into orders(id) values(1);
select * from orders;
验证结果:
| id | create_time | update_time |
|---|---|---|
| 1 | 插入时的当前时间 | 插入时的当前时间 |
可以看到,我们插入数据时只插入了 id,但 create_time 和 update_time 并不是 NULL,而是当前的系统时间——这就是显式声明自动更新的结果。下面再更新这条记录,看 update_time 是否变化:
update orders set id = 2 where id = 1;
select * from orders;
验证结果:
| 字段 | 更新后 |
|---|---|
| id | 2 |
| create_time | 不变 |
| update_time | 刷新为当前时间 |
原因很直接:create_time 只写了 default(没有 on update),所以更新时纹丝不动;update_time 多了 on update,被刷新成了"现在"。这正是一张表记录"创建时间 + 修改时间"的标准写法。
default 和 on update 一个管插入、一个管更新,可以单独用也可以一起用:
- default current_timestamp:插入时如果没给这一列赋值,就自动填当前时间。
- on update current_timestamp:这一行被更新时,自动把这一列刷新成当前时间。
既然 datetime 和 timestamp 都能自动更新,那到底该用谁?答案是:生产环境优先用 datetime。 因为 timestamp 有一个致命的时间范围限制:
- timestamp 只能存 1970-01-01 ~ 2038-01-19 之间的时间。 它内部用 4 字节的有符号秒数存储,32 位有符号整数最大是 2147483647,对应的正是 2038-01-19 这一天(著名的 2038 年问题)。超出范围,插入直接报错:
create table t_ts(t timestamp);
insert into t_ts values('2039-01-01 00:00:00');   -- 越界
验证结果:
| 语句 | 结果 |
|---|---|
| insert into t_ts values('2039-01-01 00:00:00'); | ERROR 1292 (22007): Incorrect datetime value: '2039-01-01 00:00:00' for column 't' at row 1 |
- datetime 的范围是 1000-01-01 ~ 9999-12-31,比 timestamp 大得多,而且不受系统时区影响(timestamp 存秒数,显示时会随服务器时区换算,迁移服务器后可能"看错时间")。
两者对比:
| 维度 | datetime | timestamp |
|---|---|---|
| 取值范围 | 1000-01-01 ~ 9999-12-31 | 1970-01-01 ~ 2038-01-19 |
| 是否受时区影响 | 否(存什么显示什么) | 是(按秒数换成本地时区) |
| 占用空间 | 8 字节 | 4 字节 |
| 自动更新 | ✅ 支持 | ✅ 支持 |
| 生产推荐 | ✅ 首选 | 少用 |
结论:记录"创建/修改时间"这类字段,直接上 datetime default current_timestamp [on update current_timestamp]——范围大、不受时区影响、没有 2038 隐患,是最稳妥的选择。timestamp 只有在确实需要"跨时区自动换算成 UTC"、或对 4 字节空间极度敏感时才考虑。
顺带提一句版本背景:老版本(explicit_defaults_for_timestamp = OFF,MySQL 5.7 的默认值)里,表里第一个 timestamp 列会自动获得"填当前时间 + 更新刷新"的能力;MySQL 8.0 把这个参数改成了默认 ON,隐式行为彻底移除,现在一律要显式声明。从 5.7 迁到 8.0 时,这个差异最容易让"更新时间"静默失效。
五、enum 与 set:数据库里的"选择题"
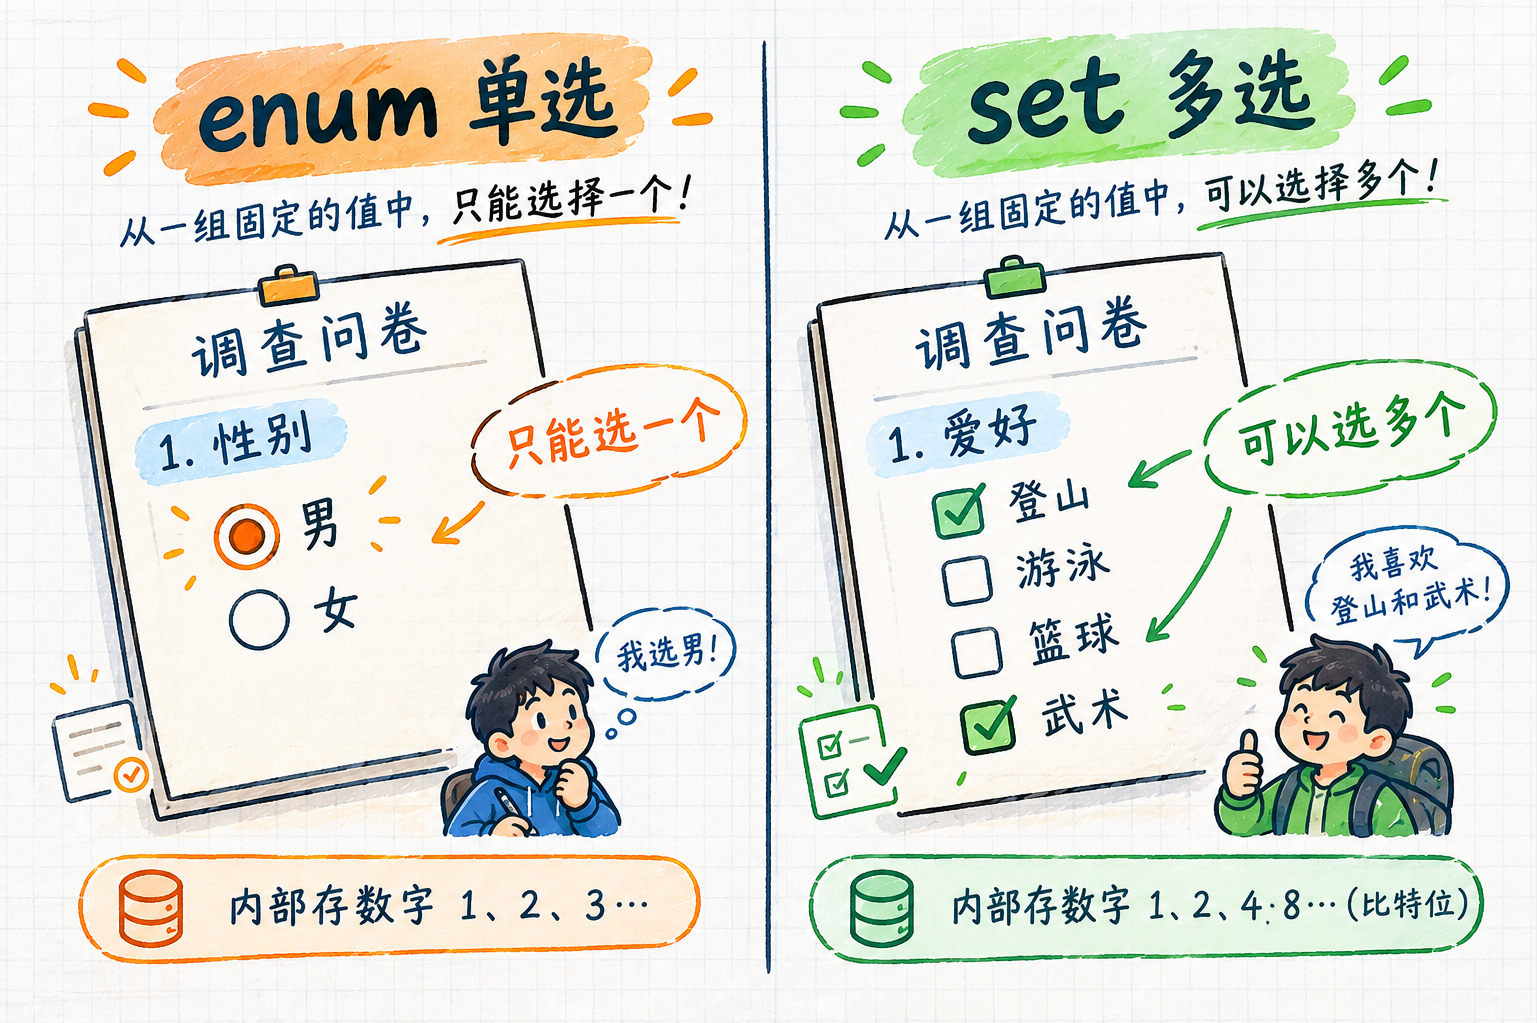
有些字段的取值是有限且固定的,例如性别的"男/女"、状态的"在职/离职"、颜色的"红/黄/蓝"。对这种数据,MySQL 提供了专门的"选择类型"——enum(单选)和 set(多选),它们比用 varchar 存更省空间、也更安全。
5.1 enum:单选
enum('选项1', '选项2', '选项3', ...) -- 枚举,单选enum 给你提供一个选项列表,一个单元格最终只能存其中某一个值。它的本质约束就是"单选"——要么选 A,要么选 B,不能既 A 又 B。
5.2 set:多选
set('选项值1', '选项值2', '选项值3', ...) -- 集合,多选set 则允许一个单元格同时存多个选项值,本质是"多选"——可以既选 A 也选 B,还可以继续选 C。
5.3 底层原理:它们存的其实是"数字"
这是 enum 和 set 最精巧、也最容易被忽视的设计:出于效率考虑,这两个类型实际存储的都是"数字",而不是字符串文本。 但它们映射数字的方式截然不同,正好对应了两种经典的数据结构:
- enum 用"数组下标":选项依次对应数字 1, 2, 3, ...,最多支持 65535 个选项。
- set 用"比特位":选项依次对应数字 1, 2, 4, 8, 16, 32, ...(即 2 的幂),最多支持 64 个选项。
看到 1, 2, 4, 8, 16... 这个数列,学过 Linux 的你应该会心一笑——这不就是权限里的比特位标志位吗?我们之前讲 Linux 文件权限(读=4、写=2、执行=1)时用的正是同一套思想:每个选项占据二进制里独立的一位,用"位或"把多个选项组合成一个数字。set 能支持多选,靠的正是这个位掩码(bitmask)机制——每一位独立表示"这个选项选没选"。
理解了这一点,两个"看似奇怪"的现象就能解释了:为什么可以用数字插入 enum/set,以及为什么 set 的取值加起来不会超过 64 个。
5.4 案例:一张"爱好调查表"
下面用一个经典案例串起 enum 和 set。假设我们做一张调查表 votes,调查人的爱好(登山、游泳、篮球、武术,可多选)和性别(男、女,单选):
create table votes(
    name varchar(30),
    hobby set('登山','游泳','篮球','武术'),   -- 多选
    gender enum('男','女')                     -- 单选
);

insert into votes values('雷锋',     '登山,武术', '男');
insert into votes values('LiLei',    '登山',      '男');
insert into votes values('LiLei',    '篮球',      '男');
insert into votes values('HanMeiMei','游泳',      '女');
验证结果:
| name | hobby | gender |
|---|---|---|
| 雷锋 | 登山,武术 | 男 |
| LiLei | 登山 | 男 |
| LiLei | 篮球 | 男 |
| HanMeiMei | 游泳 | 女 |
接下来再插入两行,验证它们的底层原理——用数字代替字符串:
insert into votes values('Juse', '登山,武术', 2);   -- 2 对应 enum 的第 2 项"女"
insert into votes values('Juse', 3, 2);             -- 3 = 1 + 2,对应 set 的前两项

select * from votes where name = 'Juse';
验证结果:
| name | hobby | gender | 说明 |
|---|---|---|---|
| Juse | 登山,武术 | 女 | 字符串写法,正常 |
| Juse | 登山,游泳 | 女 | 数字 3 被解释为 1+2 两个选项 |
注意 Juse 那两行:
- gender 用数字 2 插入,最终显示的是"女"——这就是 enum 数字映射的体现;hobby 列里 登山,武术 用逗号分隔,展示了一个单元格里同时存多个 set 选项。
- hobby 用数字 3 插入,最终显示的是"登山,游泳"——这是 set 比特位映射的体现:3 = 1 + 2,第 1 位"登山"和第 2 位"游泳"被同时置位。
虽然可以用数字来插入枚举值和集合值,但日常使用时不建议这么做——用数字不利于阅读,时间一长你根本分不清 2 到底是"女"还是"游泳",徒增维护成本。写 SQL 时老老实实用字符串选项值,清晰又安全。
5.5 find_in_set:正确查询"多选"字段
关于 set,查询时有一个非常重要的问题。现在有个需求:查出所有喜欢"登山"的人。很多人的第一反应是这么写:
select * from votes where hobby = '登山';验证结果:
| 语句 | 结果 |
|---|---|
| select * from votes where hobby = '登山'; | 只返回 LiLei 一行 |
查询结果漏了"雷锋"——因为他的 hobby 是 登山,武术,整串不等于 登山。这就是 set 字段查询的第一个坑:用 = 只能匹配到"恰好等于"的整串,查不出"包含"某选项的行。
正确的做法是用 find_in_set 函数:
find_in_set(sub, str_list) -- 如果 sub 在逗号分隔的 str_list 中,返回其下标;否则返回 0先感受一下它的行为:
select find_in_set('a', 'a,b,c');   -- 1
select find_in_set('d', 'a,b,c');   -- 0
验证结果:
| 语句 | 返回值 | 说明 |
|---|---|---|
| select find_in_set('a', 'a,b,c'); | 1 | 'a' 在第 1 位 |
| select find_in_set('d', 'a,b,c'); | 0 | 'd' 不在列表中 |
于是,查"喜欢登山的人"应该这样写:
select * from votes where find_in_set('登山', hobby);验证结果:
| 语句 | 结果 |
|---|---|
| select * from votes where find_in_set('登山', hobby); | 返回 4 行:雷锋、LiLei、Juse(两行),只要 hobby 里含 登山 就能命中 |
这次只要 hobby 里包含"登山",无论它是单独出现还是和别的选项组合,都能被查出来。
find_in_set 返回值非 0 表示"找到了",而 where 条件里非 0 即真,所以 where find_in_set('登山', hobby) 等价于"hobby 里包含登山"。这是 set 字段查询的标准姿势,务必记住——用 = 查 set 是新手最常犯的错。
另外注意:find_in_set 无法使用索引,全表扫描。如果多选查询是高频操作,正确做法是拆成关联表(一个选项一行),而不是依赖 set。
六、实战:一张订单表的字段选型
前面五章是"逐个类型拆解",这一章把它们串起来——用一张真实的订单表,看看选错类型会付出什么代价。
6.1 需求
订单表要存四个字段:订单金额、订单状态、创建时间、会员到期时间。
6.2 一份"看起来能跑"的错误建表
create table orders_bad (
  id         int,
  amount     float,          -- 坑一
  status     varchar(20),    -- 坑二
  created_at timestamp,      -- 坑三
  expire_at  timestamp       -- 坑三
);
这份 DDL 能建表、能插入、能查询,测试环境跑得好好的。三个坑都在数据量上来之后才爆发。
##### 6.2.1 坑一:金额用 float,累加对不上账
insert into orders_bad(id, amount) values (1, 0.1), (2, 0.2);

select sum(amount) from orders_bad;   -- 0.30000001192092896
select sum(amount) = 0.3;             -- 0
验证结果:
| 语句 | 结果 |
|---|---|
| select sum(amount) from orders_bad; | 0.30000001192092896 |
| select sum(amount) = 0.3; | 0(不相等) |
原因在 2.2.1 节已经讲过:float 是 IEEE 754 二进制近似,0.1 和 0.2 都无法精确表示。单条记录看起来是 0.10,但误差会在累加中放大——一亿条订单累加,差出几百块是常态。
更麻烦的是这类误差"不报错、不告警",等你发现的时候,账已经对不上了。
结论:金额一律用 decimal(18,2),并且应用层用 BigDecimal(Java)或 decimal(Python)而非 double 接收。
##### 6.2.2 坑二:状态用 varchar,等于放弃了数据校验
insert into orders_bad(status) values('已付款'), ('已付'), ('已 付款');

select status, count(*) from orders_bad group by status;
验证结果:
| status | count |
|---|---|
| 已付款 | 1 |
| 已付 | 1 |
| 已 付款 | 1 |
三个"看起来一样"的状态,在数据库里是三个不同的值。后续 where status = '已付款' 只能查到 1 条,另外 2 条永远漏掉——这不是偶发 bug,是必然的统计错误。
结论:选项固定的字段,用 tinyint 配代码里的枚举(扩展性好、索引小),或者用 enum(简单,但改选项要 DDL)。
为什么我更推荐 tinyint + 字典?因为 enum 增加选项需要 alter table ... modify column,在千万级表上是一次锁表操作;而 tinyint 加一个状态值只需要改代码。
##### 6.2.3 坑三:timestamp 存不到 2038 年以后
insert into orders_bad(expire_at) values('2040-01-01 00:00:00');验证结果:
| 语句 | 结果 |
|---|---|
| insert into orders_bad(expire_at) values('2040-01-01 00:00:00'); | ERROR 1292 (22007): Incorrect datetime value: '2040-01-01 00:00:00' for column 'expire_at' at row 1 |
"会员到期时间"这类业务上可能超过 2038 年的时间,用 timestamp 直接写不进去。这不是理论问题——20 年期的会员卡、长期合同、保险到期日,现在就在踩这个坑。
结论:timestamp 只用于"记录事件发生时刻"(如 created_at);业务上的"未来时间点"必须用 datetime。
6.3 修正后的建表
create table orders (
  id         bigint unsigned auto_increment primary key,
  order_no   char(32)      not null,          -- 定长单号,用 char
  amount     decimal(18,2) not null,          -- 金额,decimal
  status     tinyint       not null default 0,-- 状态,tinyint + 字典
  created_at datetime      not null default current_timestamp,
  updated_at datetime      not null default current_timestamp on update current_timestamp,
  expire_at  datetime      null               -- 未来时间点,datetime
) engine=InnoDB default charset=utf8mb4;
验证结果:
| 验证点 | 语句 | 结果 |
|---|---|---|
| 精度 | 插入 0.10 + 0.20,select sum(amount) | 0.30,精确 |
| 范围 | insert ... (expire_at) values('2040-01-01 00:00:00') | Query OK |
| 自动时间 | 只插 order_no 和 amount | created_at、updated_at 自动填当前时间 |
| 更新刷新 | update orders set status = 1 | 只有 updated_at 变化 |
同一份业务需求,换一套类型,四个问题全部消失。
6.4 三个高频踩坑记录
- 联合索引里塞了多个 varchar(255),建索引直接失败
create table t_idx (
  a varchar(255), b varchar(255),
  c varchar(255), d varchar(255)
) charset=utf8mb4;

alter table t_idx add index idx_abcd(a, b, c, d);
验证结果:
| 语句 | 结果 |
|---|---|
| alter table t_idx add index idx_abcd(a, b, c, d); | ERROR 1071 (42000): Specified key was too long; max key length is 3072 bytes |
utf8mb4 下每字符 4 字节,4 × 255 × 4 = 4080 字节,超过 InnoDB 的 3072 字节上限。
修复:把列缩到 varchar(191)(191 × 4 × 4 = 3056 ≤ 3072),或用前缀索引 index idx(a(64), b(64))。
- decimal(10,2) 按"当前业务量"设计,两年后溢出
create table t_dec(amount decimal(10,2));   -- 上限 99999999.99
insert into t_dec values(100000000.00);
验证结果:
| 语句 | 结果 |
|---|---|
| insert into t_dec values(100000000.00); | ERROR 1264 (22003): Out of range value for column 'amount' at row 1 |
decimal(10,2) 只能存 8 位整数部分(最大 99999999.99)。业务量涨到亿级后,insert 直接失败。
修复:金额字段一步到位给 decimal(18,2),别按当前业务量估算——类型升级意味着改表,代价远大于一开始多占几个字节。
- 用 char(255) 存身份证号,不报错但索引臃肿
create table t_card(card char(255), index idx(card)) charset=utf8mb4;这条语句不会报错(255 × 4 = 1020 < 3072),但索引项长度是 char(18) 的约 14 倍。同样 16KB 的索引页,能放的条目少一个数量级,等值查询的磁盘 IO 次数随之上升。
修复:定长字段按实际长度声明,身份证 char(18)、手机号 char(11)、MD5 char(32)。char 的价值在于"长度确定",写 255 就浪费了这个优势。
七、版本差异与迁移注意
本文示例基于 MySQL 8.0,但很多线上库还在 5.7。下面这些差异会直接影响本文的结论:
| 项目 | MySQL 5.7 | MySQL 8.0 | 迁移影响 |
|---|---|---|---|
| 默认字符集 | latin1 | utf8mb4 | 同一个 varchar(n),8.0 下 n 上限从 21844 降到 16383,索引字节数翻倍 |
| utf8 的含义 | 别名 utf8mb3 | 同为 utf8mb3,已废弃 | 新项目一律直接写 utf8mb4 |
| float(M,D) / double(M,D) | 可用 | 8.0.17 起废弃(仍可用,有告警) | 新代码直接写 float / double |
| timestamp 隐式默认值 | explicit_defaults_for_timestamp=OFF,首个 timestamp 列自动获得 default + on update | 默认 ON,必须显式声明 | 5.7 升 8.0 后"自动更新时间"会静默失效,必须补 on update |
| TEXT/BLOB 默认值 | 不支持 | 8.0.13 起支持表达式默认值 | 老代码里用触发器兜底的场景可以简化 |
| 默认排序规则 | utf8mb4_general_ci | utf8mb4_0900_ai_ci | 迁移后 order by 结果可能变化(大小写、重音的处理不同) |
迁移前建议跑一遍 select version(), @@character_set_server, @@collation_server, @@explicit_defaults_for_timestamp;,把四个值记下来,再对照上表逐项检查。
八、总结
让我们用"是什么 → 为什么 → 怎么做"的框架,把全文串起来:
| 维度 | 核心内容 | 一句话记忆 |
|---|---|---|
| 是什么 | 数据类型是"存储空间、取值范围、比较规则"的统一契约;四大类:数值、字符串、日期时间、enum/set | 类型即契约,选错步步错 |
| 为什么 | 类型决定存储开销(char 浪费空间 vs varchar 省空间)、精度(float 丢 vs decimal 准)、范围(tinyint 越界)、查询行为(set 用 = 查不全) | 每种类型都有它的脾气 |
| 怎么做 | 整数按范围选、小数精度敏感用 decimal、字符串按长度定长/变长、时间字段显式声明自动更新、有限选项用 enum/tinyint | 按需选型,各有分工 |
四个最该带走的认知:
- 越界是"硬约束":整数、小数都有明确的取值范围,插超了直接报错(Out of range / Data too long)。选类型前先想清楚这一列可能出现的最大/最小值。
- 精度敏感的数据远离 float:float 约 7 位有效精度,金额、余额这类"一分不能差"的字段必须用 decimal。
- 定长 char、变长 varchar:长度万年不变(身份证、MD5)用 char 换效率;长度有变化(姓名、地址)用 varchar 省空间,并保证最长值能存下。
- 多选查询别用 =:set 字段要查"包含某选项",用 find_in_set(sub, col);enum 单选才用 =。
8.1 选型速查表
建表时直接对着这张表找:
| 业务字段 | 推荐类型 | 理由 |
|---|---|---|
| 主键 | bigint unsigned auto_increment | int 约 21 亿会用完,主键类型升级代价极高 |
| 金额 / 单价 | decimal(18,2) | 精确,且为业务增长留足整数位 |
| 状态 / 类型 | tinyint(配代码字典)或 enum | 存储小、能挡脏数据;tinyint 扩展无需 DDL |
| 身份证 / 手机号 / MD5 | char(18) / char(11) / char(32) | 定长,索引紧凑,查询快 |
| 姓名 / 地址 / 标题 | varchar(实际最大值) | 变长省空间,但别一律写 255 |
| 创建 / 更新时间 | datetime default current_timestamp(+ on update) | 无 2038 问题,不受时区影响 |
| 未来时间点(到期、预约) | datetime | timestamp 存不进去 |
| 事件发生时刻(需跨时区统一) | timestamp | 内部存 UTC 秒数,可自动换算 |
| 多选标签 | set(低基数、查询少)或关联表 | set 简单但 find_in_set 不走索引 |
| 长文本 / 富文本 | text / mediumtext | 避免撑爆单行长度限制 |
8.2 动手试试
亲手复现一次越界:建一张表,含 tinyint、tinyint unsigned、bit(1) 三列,分别尝试插入 127、128、-1、255、2,观察哪些成功、哪些报错,并记录每个报错的错误码(1264 还是 1406)。 提示:对照正文里"越界报错 vs 数据太长"的区别,理解两种错误的本质差异。 验证 float 与 decimal 的精度差异:建一张表含 float(10,8) 和 decimal(10,8) 两列,向两列插入同一个多位数小数 23.12345612,查询对比结果。 提示:重点看 float 那列末尾几位是否发生了"静默改变",再想想 select 0.1+0.2 为什么反而等于 0.3。 用 find_in_set 查多选:建一张 votes 表(hobby set、gender enum),插入几条含组合爱好的数据,先用 where hobby='登山' 查,再用 where find_in_set('登山', hobby) 查,对比两个结果集的差异。 提示:这是 set 字段最经典的坑,亲手踩一遍、再看一遍差异,印象最深刻。 复现 2038 问题:建一张含 timestamp 列的表,插入 '2040-01-01 00:00:00',把报错信息和你业务里的"到期时间"字段对照一下。
预告: 选好了类型,下一步就是给这些列装上约束,守住数据的合法性。下一篇我们将进入 MySQL 表的约束:从 not null 到外键,给数据装上"合法性防线",系统学习 not null、default、主键、唯一键、外键等约束,让数据真正可靠起来。
尾声
本章讲解就到此结束了,若有纰漏或不足之处欢迎大家在评论区留言或者私信,同时也欢迎各位一起探讨学习。感谢您的观看!
更多内容可见主页
标签
转载自: https://blog.csdn.net/2302_80243065/article/details/168975350


