

2026年 IndexTTS2.5 与 OmniVoice 多语言克隆评测:ECAPA-TDNN 声纹相似度计算流程与复现代码
2026 年 IndexTTS2.5 与 OmniVoice 多语言零样本克隆横向评测:用 ECAPA-TDNN 声纹相似度对比日语、西语表现,附完整计算流程、可复现 Python 代码与三个常见误区。
2026年 IndexTTS2.5 与 OmniVoice 多语言克隆评测:ECAPA-TDNN 声纹相似度计算流程与复现代码
更新于 2026 年 10 月 · 评测数据来自 IndexTTS2 在线版公开实测(测试日期 2026-08-13)
用 ECAPA-TDNN 声纹相似度对比 IndexTTS2.5 和 OmniVoice 的零样本克隆:日语两者近似持平(0.8776 对 0.8815),西班牙语 OmniVoice 明显更像参考人(0.8010 对 0.6748)。 这个指标的算法是把参考音和生成音各编码成一个 192 维说话人向量,再算余弦相似度。本文给出完整的计算流程和可直接运行的 Python 代码,并重点讲三件容易做错的事:不同语言之间的相似度不能直接比,要先跑同人基线,声纹相似度不等于读得准。
一、评测 TTS 声音克隆,到底要测哪几个指标?
至少测三个维度,各自对应不同的指标,不能互相替代:
| 维度 | 回答的问题 | 指标 | 工具 |
|---|---|---|---|
| 音色相似度 | 像不像参考说话人 | 说话人向量余弦相似度(SS) | SpeechBrain ECAPA-TDNN |
| 韵律 | 音高、节奏贴不贴原声 | 基频中位数误差、停顿统计 | librosa pyin、能量切分 |
| 可懂度 | 字读没读对 | WER / CER | Whisper + jiwer |
本文的数据只覆盖前两个维度。原始样本没有保存合成时用的目标文本,没有参考文本就没法算 CER,这一点在第六节单独说明怎么补。
很多对比文章只报一个「相似度」就下结论说「A 模型发音更好」,这是把音色和可懂度混在了一起。声纹模型训练时学的是区分说话人,它对一个字读成了另一个字几乎不敏感。
二、实验怎么设计,才能比出模型差异而不是录音差异?
核心原则是控制变量:除了模型,其他全部一样。
| 条件 | 本次设置 | 为什么 |
|---|---|---|
| 参考音 | 两个模型用同一段参考音 | 参考音不同,比出来的是说话人差异 |
| 语种 | 日语、西班牙语各一组 | 两个模型都支持这两种语言 |
| 生成条件 | 中性语气;IndexTTS2.5 另加「悲伤 0.6」「降速」 | 中性版做横向对比,情绪版看参数是否生效 |
| 预处理 | 全部转 16 kHz、单声道 | ECAPA 预训练模型在 16 kHz 上训练,采样率不一致会让向量偏移 |
| 停顿阈值 | 180 ms | 低于这个时长的静音多是正常的音节间隙 |
两个模型的背景:IndexTTS2.5 由 B 站 IndexSpeech 团队于 2026 年 8 月 10 日发布,官方支持中英日西阿五种语言;OmniVoice 由 k2-fsa(新一代 Kaldi)团队开源,官方仓库写明支持 600 多种语言。两者都是零样本模型:不需要针对说话人训练,给几秒参考音就能模仿音色。
三、ECAPA-TDNN 声纹相似度怎么算?
3.1 原理:为什么选 ECAPA-TDNN
ECAPA-TDNN 是一个说话人识别模型,SpeechBrain 提供了在 VoxCeleb 数据集上训练好的版本。它把任意长度的语音压缩成一个 192 维向量(speaker embedding),训练目标是让同一个人的不同录音向量靠近、不同人的向量远离。
所以两个向量的余弦相似度,可以直接理解为「这两段声音是同一个人的可能性」。和 MFCC 这类声学特征比,它有两个优点:
- 对说的内容不敏感:参考音和生成音的文本不同也能比。MFCC 会把内容差异算进去,不同文本之间比较波动很大。
- 对录音条件相对鲁棒:训练数据本身来自各种环境的采访录音。
3.2 代码:加载与统一采样率
环境:Python 3.10,speechbrain>=1.0、torch、torchaudio、librosa、numpy。
python
import torch
import torchaudio

TARGET_SR = 16000

def load_16k_mono(path: str) -> torch.Tensor:
    """读取音频,转单声道、重采样到 16 kHz,返回 [1, T]"""
    wav, sr = torchaudio.load(path)
    if wav.shape[0] > 1:
        wav = wav.mean(dim=0, keepdim=True)
    if sr != TARGET_SR:
        wav = torchaudio.functional.resample(wav, sr, TARGET_SR)
    return wav
3.3 代码:提取说话人向量并计算相似度
python
import torch.nn.functional as F
from speechbrain.inference.speaker import EncoderClassifier

encoder = EncoderClassifier.from_hparams(
    source="speechbrain/spkrec-ecapa-voxceleb",
    savedir="pretrained/ecapa",
    run_opts={"device": "cuda" if torch.cuda.is_available() else "cpu"},
)

@torch.no_grad()
def embed(path: str) -> torch.Tensor:
    wav = load_16k_mono(path).to(encoder.device)
    return encoder.encode_batch(wav).squeeze()      # [192]

def speaker_sim(ref_path: str, gen_path: str) -> float:
    return F.cosine_similarity(embed(ref_path), embed(gen_path), dim=0).item()
encode_batch 的输入形状是 [batch, time],单条音频的 [1, T] 正好是 batch=1,输出 [1, 1, 192],squeeze() 后得到向量。
3.4 关键一步:先跑同人基线
相似度的绝对值本身没有意义,要和「同一个人两段真录音」的相似度对比才知道好坏。 做法是把参考原声切成两半,或者找同一人的另一段录音:
python
def baseline(ref_a: str, ref_b: str) -> float:
    """同一说话人两段真实录音的相似度,作为上限参照"""
    return speaker_sim(ref_a, ref_b)
如果同人基线是 0.85,生成音达到 0.83,说明已经非常接近真人水平;如果同人基线只有 0.70(录音质量差、两段情绪差异大),那生成音 0.68 也是好成绩。不跑基线就说「0.68 不够像」,结论可能是错的。
3.5 不同语言之间的相似度不能直接比
这是最容易踩的坑。ECAPA 的训练数据 VoxCeleb 以英语为主,它对不同语言的语音,向量分布本身就不一样。本次结果里日语 0.88、西班牙语 0.67,不能解读为「两个模型做西语都比日语差」,只能在同一语言内部比较两个模型。
跨语言要比较,正确做法是每种语言各自跑同人基线,用「生成音相似度 ÷ 同人基线」归一化以后再比。
四、基频和停顿怎么测?
4.1 基频中位数误差
基频(F0)是声带振动的频率,听感上就是音高。日语是有高低音调的语言,同一个词音调不同意思可能不同,所以对日语配音来说,基频比对中文、英文更重要。
python
import librosa
import numpy as np

def f0_median(path: str, fmin: float = 60, fmax: float = 500) -> float:
    y, sr = librosa.load(path, sr=TARGET_SR)
    f0, voiced, _ = librosa.pyin(y, fmin=fmin, fmax=fmax, sr=sr)
    return float(np.nanmedian(f0[voiced]))

def f0_err(ref_path: str, gen_path: str) -> float:
    r, g = f0_median(ref_path), f0_median(gen_path)
    return abs(g - r) / r
几个参数的取法:
- 用中位数而不是平均值:pyin 偶尔会把清音段误判出极端值,中位数不受影响。
- fmin / fmax 按说话人设:男声一般 60–300 Hz,女声 100–500 Hz。范围太宽会增加倍频误判。
- 只统计有声帧:
voiced为 False 的帧 f0 是 NaN,必须先过滤。
4.2 停顿与有效语音占比
python
def pause_stats(path: str, min_gap: float = 0.18, top_db: float = 35):
    y, sr = librosa.load(path, sr=TARGET_SR)
    iv = librosa.effects.split(y, top_db=top_db)        # 非静音区间(采样点)
    gaps = [(iv[i + 1][0] - iv[i][1]) / sr for i in range(len(iv) - 1)]
    long_gaps = [g for g in gaps if g >= min_gap]
    voiced_ratio = sum(e - s for s, e in iv) / len(y)
    return {
        "duration_s": len(y) / sr,
        "pauses": len(long_gaps),
        "pause_total_s": sum(long_gaps),
        "voiced_ratio": voiced_ratio,
    }
180 ms 阈值和 16 kHz 是原实测给出的设置;top_db=35 是复现时的示例值,原实测没有公开。这个参数对结果影响很大:底噪高的录音要调小,否则噪声会被当成语音,停顿就测不出来。建议先拿参考原声调参,让它的停顿统计符合听感,再用同一参数跑所有生成音。
4.3 汇总脚本
python
import csv

SAMPLES = {
    "ja": {"ref": "ja_ref.wav",
           "IndexTTS2.5": "ja_indextts25_neutral.wav",
           "OmniVoice": "ja_omnivoice_neutral.wav"},
    "es": {"ref": "es_ref.wav",
           "IndexTTS2.5": "es_indextts25_neutral.wav",
           "OmniVoice": "es_omnivoice_neutral.wav"},
}

with open("results.csv", "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["lang", "model", "speaker_sim", "f0_err", "pauses", "voiced_ratio"])
    for lang, files in SAMPLES.items():
        for model in ("IndexTTS2.5", "OmniVoice"):
            gen = files[model]
            ps = pause_stats(gen)
            w.writerow([lang, model,
                        round(speaker_sim(files["ref"], gen), 4),
                        round(f0_err(files["ref"], gen), 4),
                        ps["pauses"], round(ps["voiced_ratio"], 3)])
五、IndexTTS2.5 和 OmniVoice 的结果怎么解读?
5.1 中性克隆
| 语言 | 模型 | 声纹相似度 | 基频中位数误差 |
|---|---|---|---|
| 日语 | IndexTTS2.5 | 0.8776 | 1.8% |
| 日语 | OmniVoice | 0.8815 | 8.4% |
| 西班牙语 | IndexTTS2.5 | 0.6748 | 7.4% |
| 西班牙语 | OmniVoice | 0.8010 | 5.4% |
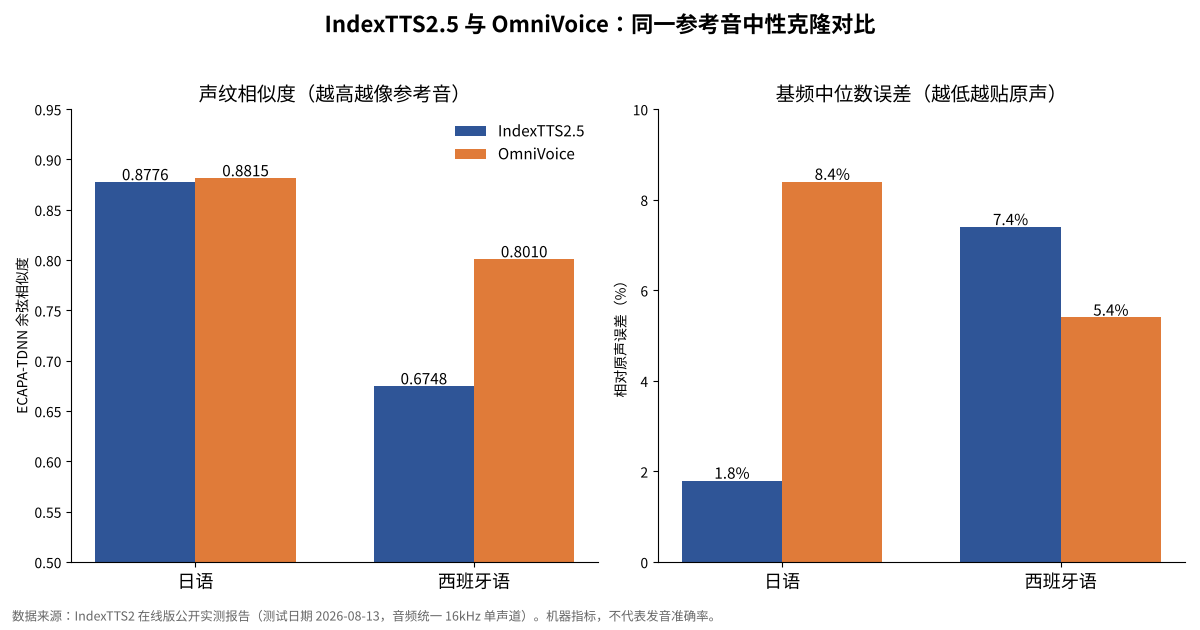
中性克隆声纹与基频对比图
日语:声纹差 0.0039,在单组样本里属于测量噪声范围,只能说持平。真正拉开差距的是基频,IndexTTS2.5 误差 1.8%,OmniVoice 8.4%。工程含义是:做日语角色配音,IndexTTS2.5 的语调更像参考人在说话,这对有音调区别的日语尤其关键。
西班牙语:声纹差 0.13,而且基频也是 OmniVoice 更准,两个指标方向一致,这组样本里结论比较明确。但按第 3.5 节,0.6748 这个绝对值不能和日语的 0.88 放在一起说「IndexTTS2.5 西语很差」,只能说在这组西语样本上不如 OmniVoice。
5.2 情绪参数有没有生效
IndexTTS2.5 支持情绪控制。把中性调到「悲伤 0.6」,看声学特征的变化:
| 语言 | 时长 | 停顿总量 | 基频中位数 | 声纹相似度 中性 → 悲伤 |
|---|---|---|---|---|
| 日语 | +59.5% | +136.8% | +19.4% | 0.8776 → 0.6948 |
| 西班牙语 | +13.5% | +13.8% | +14.0% | 0.6748 → 0.8434 |
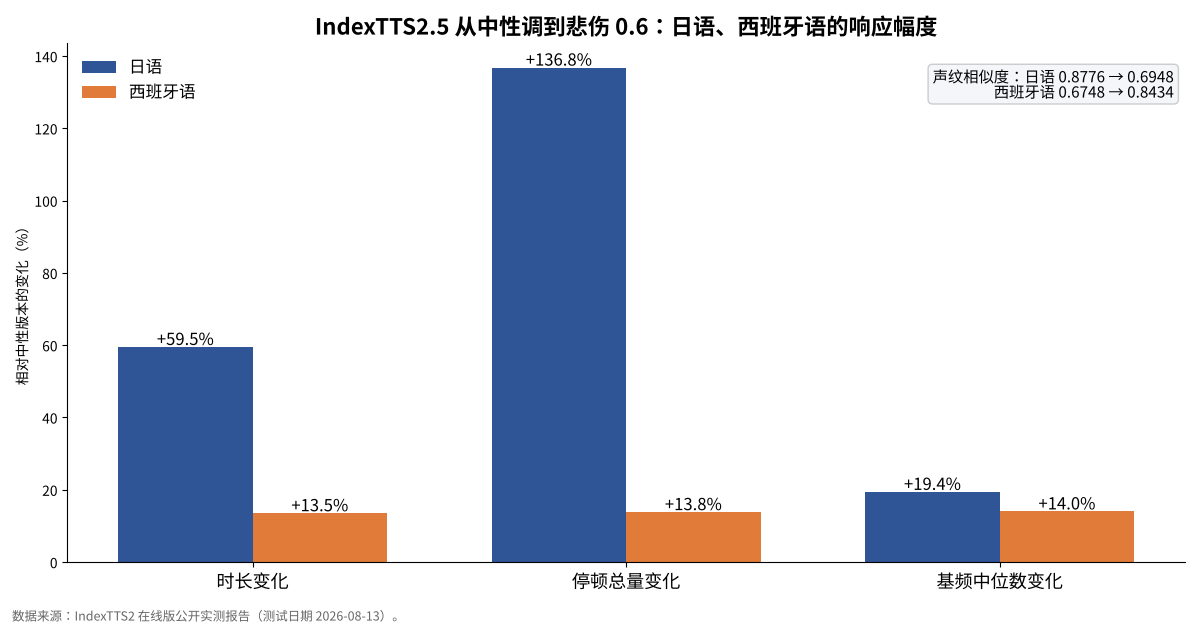
情绪变化数据图
三个结论:
- 参数确实生效了:时长、停顿、基频都有可测的变化。
- 同样的强度,不同语言的响应幅度差约 4 倍:日语时长 +59.5%,西语 +13.5%。所以「悲伤 0.6」在不同语言里不是同一个主观强度,调参要按语言分开。
- 强情绪会拉低日语的声纹相似度:降了 0.18。悲伤改变了语速、音高和共鸣,声纹模型就认为不太像同一个人了。做日语情绪配音,强度从 0.3–0.4 开始试比较稳。
西班牙语加了情绪后相似度反而升高(0.6748 → 0.8434),原因不明。一种可能是这位参考人原声的语气本身偏低沉,悲伤版更接近原声的说话状态,但单组样本无法验证。
六、这套评测还缺什么?怎么补?
| 缺口 | 影响 | 补法 |
|---|---|---|
| 没有 CER / WER | 不知道字读没读对 | 合成时保存文本;用 Whisper large-v3 转写,jiwer 计算。日语、中文用 CER(字错误率),因为没有空格分词;西语、英语用 WER |
| 每语种只有一组参考音 | 结论只对这个音色成立 | 每个语种至少 5 个说话人、男女各半,报均值和标准差 |
| 没有同人基线 | 绝对值不好解读 | 按第 3.4 节补跑 |
| 没有主观评分 | 不能说哪个更自然 | 3 人以上母语者盲听打分(MOS),随机打乱顺序 |
| OmniVoice 没有情绪样本 | 不能比较情绪能力 | 用 OmniVoice 的语气控制生成同类样本 |
补 CER 的代码骨架:
python
import whisper, jiwer

asr = whisper.load_model("large-v3")

def cer(gen_path: str, ref_text: str, lang: str) -> float:
    hyp = asr.transcribe(gen_path, language=lang)["text"]
    return jiwer.cer(ref_text, hyp)
原实测里有一条单人主观试听的记录:试听者认为 IndexTTS2.5 的日语和西班牙语发音更自然。这和西语声纹落后并不矛盾,「发音自然」和「像不像本人」是两个维度。但单人试听不能当结论,补上 CER 和多人盲听才能下判断。
七、按这组数据,该选哪个模型?
| 需求 | 建议 | 依据 |
|---|---|---|
| 日语角色配音、要情绪 | IndexTTS2.5 | 基频误差 1.8%,情绪可控 |
| 西班牙语,最在意像不像本人 | OmniVoice,或两个各跑一版 | 这组样本声纹 0.80 对 0.67 |
| 正式选型 | 用本文脚本跑自己的参考音 | 单组样本不代表你的音色 |
| 需要情绪 + 多语种 | IndexTTS2.5,强度按语言分别调 | 同强度跨语言响应差约 4 倍 |
这套脚本跑一组样本,在单张消费级显卡上几分钟就能出结果,换模型、换音色都只需要改文件路径。选型时花这几分钟自己测一遍,比看任何榜单都可靠。
常见问题
ECAPA 声纹相似度多少算像? 没有通用阈值,要和同一说话人两段真录音的相似度比。经验上同人真录音多在 0.8 以上,但受录音条件影响很大,所以第 3.4 节的同人基线是必做步骤。
为什么不用 MFCC 余弦相似度? MFCC 同时编码了说话内容和录音条件,文本不同的两段音频比较时波动很大。ECAPA 是专门训练来区分说话人的,对文本内容不敏感,更适合回答「像不像」。
日语和西语的相似度能放在一起比吗? 不能直接比。ECAPA 的训练数据以英语为主,不同语言的向量分布不同。要跨语言比较,先各自跑同人基线做归一化。
这套方法能测中文吗? 可以,代码不用改,中文再加一个 CER(推荐 Paraformer 或 Whisper 转写)就是完整的中文克隆评测。
IndexTTS2.5 和 OmniVoice 的开源协议一样吗? 不一样。IndexTTS2.5 采用 bilibili 模型使用许可协议,OmniVoice 采用 Apache-2.0。商用前要各自看许可原文。
相关资源
- IndexTTS 官方仓库:https://github.com/index-tts/index-tts
- OmniVoice 官方仓库:https://github.com/k2-fsa/OmniVoice
- SpeechBrain ECAPA-TDNN 模型:https://huggingface.co/speechbrain/spkrec-ecapa-voxceleb
数据说明:中性与情绪结果来自 IndexTTS2 在线版公开实测(测试日期 2026-08-13);模型发布信息来自两个官方仓库(2026 年 10 月查阅)。文中「西语加情绪后相似度升高」的原因属于推测。
转载自: https://blog.csdn.net/weixin_72385387/article/details/169252332


